Tutorial: Fine-Tuning IndoBERTweet dengan PyTorch
- PyTorch
- Transformers
- Sentiment Analysis
- Indonesian NLP
Fine-tuning dimulai dari model pralatih, lalu memperbarui parameternya untuk tugas tertentu. Dalam tutorial ini, kita menggunakan IndoBERTweet untuk mengklasifikasikan teks bahasa Indonesia menjadi positif, negatif, atau netral.
Kita akan menulis training loop dengan PyTorch dan menggunakan Hugging Face Transformers untuk tokenizer serta modelnya. Contoh ini diadaptasi dari project analisis sentimen saya, tetapi bisa diikuti dalam notebook baru tanpa menjalankan project tersebut.
1. Siapkan lingkungan dan data
Gunakan Python 3.11 atau 3.12. Versi paket berikut mengikuti lingkungan project:
pip install torch==2.7.1 transformers==4.53.1 pandas==2.3.0 scikit-learn==1.6.1
Siapkan CSV UTF-8 bernama sentiment.csv dengan kolom text dan sentiment. Contohnya:
text,sentiment
"Pelayanannya cepat dan ramah",positive
"Aplikasinya sering error",negative
"Pembaruan tersedia hari ini",neutral
Baris-baris tersebut hanya menunjukkan formatnya, belum cukup sebagai data pelatihan. Kamu perlu cukup contoh berlabel dari setiap kelas agar data bisa dibagi menjadi set pelatihan, validasi, dan pengujian.
import pandas as pd
import torch
from sklearn.model_selection import train_test_split
from sklearn.metrics import classification_report, f1_score
from torch.utils.data import Dataset, DataLoader
from transformers import (
    AutoTokenizer, AutoModelForSequenceClassification,
    DataCollatorWithPadding, set_seed,
)

set_seed(42)
label2id = {"neutral": 0, "positive": 1, "negative": 2}
id2label = {value: key for key, value in label2id.items()}

df = pd.read_csv("sentiment.csv")
assert not df[["text", "sentiment"]].isna().any().any()
df["text"] = df["text"].astype(str).str.strip()
assert df["text"].ne("").all()
assert df["sentiment"].isin(label2id).all()
assert df.groupby("text")["sentiment"].nunique().le(1).all()
df = df.drop_duplicates("text").reset_index(drop=True)
df["label"] = df["sentiment"].map(label2id)

train_val, test = train_test_split(
    df, test_size=0.2, stratify=df["label"], random_state=42,
)
train, val = train_test_split(
    train_val, test_size=0.25,
    stratify=train_val["label"], random_state=42,
)
Pembagian ini menghasilkan proporsi 60/20/20 secara terstratifikasi. Hapus teks duplikat sebelum pembagian agar contoh identik tidak masuk ke partisi berbeda. Jika ada pengguna, percakapan, atau teks yang hampir sama dan berulang, periksa juga tumpang tindih tersebut.
2. Ubah teks menjadi batch
Tokenizer mengubah teks menjadi ID token dan attention mask. Gunakan tokenizer yang sesuai dengan checkpoint model.
checkpoint = "indolem/indobertweet-base-uncased"
tokenizer = AutoTokenizer.from_pretrained(checkpoint)

class SentimentDataset(Dataset):
    def __init__(self, frame):
        self.frame = frame.reset_index(drop=True)

    def __len__(self):
        return len(self.frame)

    def __getitem__(self, index):
        row = self.frame.iloc[index]
        item = tokenizer(row["text"], truncation=True, max_length=128)
        item["labels"] = int(row["label"])
        return item

collator = DataCollatorWithPadding(tokenizer=tokenizer)

def make_loader(frame, shuffle=False):
    return DataLoader(
        SentimentDataset(frame), batch_size=16,
        shuffle=shuffle, collate_fn=collator,
    )

train_loader = make_loader(train, shuffle=True)
val_loader = make_loader(val)
test_loader = make_loader(test)
Collator menambahkan padding pada setiap batch hingga sepanjang urutan terpanjang di batch tersebut. Pada contoh ini, urutan dibatasi hingga 128 token. Periksa panjang teks sebelum memilih batas untuk dataset lain.
3. Muat model dan siapkan evaluasi
Model klasifikasi urutan menambahkan lapisan prediksi pada encoder. Memberikan labels saat memanggil metode forward juga menghitung loss klasifikasi. Panduan klasifikasi teks Hugging Face menjelaskan antarmuka tokenizer dan model secara lebih terperinci.
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = AutoModelForSequenceClassification.from_pretrained(
    checkpoint, num_labels=3,
    label2id=label2id, id2label=id2label,
).to(device)
optimizer = torch.optim.AdamW(model.parameters(), lr=3e-5)

@torch.no_grad()
def predict(model, loader):
    model.eval()
    actual, predicted = [], []
    for batch in loader:
        actual.extend(batch["labels"].tolist())
        inputs = {key: value.to(device) for key, value in batch.items()}
        logits = model(**inputs).logits
        predicted.extend(logits.argmax(dim=-1).cpu().tolist())
    return actual, predicted
Evaluasi menggunakan model.eval() untuk mengubah perilaku khusus pelatihan seperti dropout, serta torch.no_grad() agar gradien tidak dilacak.
4. Tulis training loop
Untuk setiap batch, hitung loss, lakukan backpropagation, lalu perbarui parameter. Evaluasi setelah setiap epoch dan simpan checkpoint dengan macro-F1 validasi tertinggi.
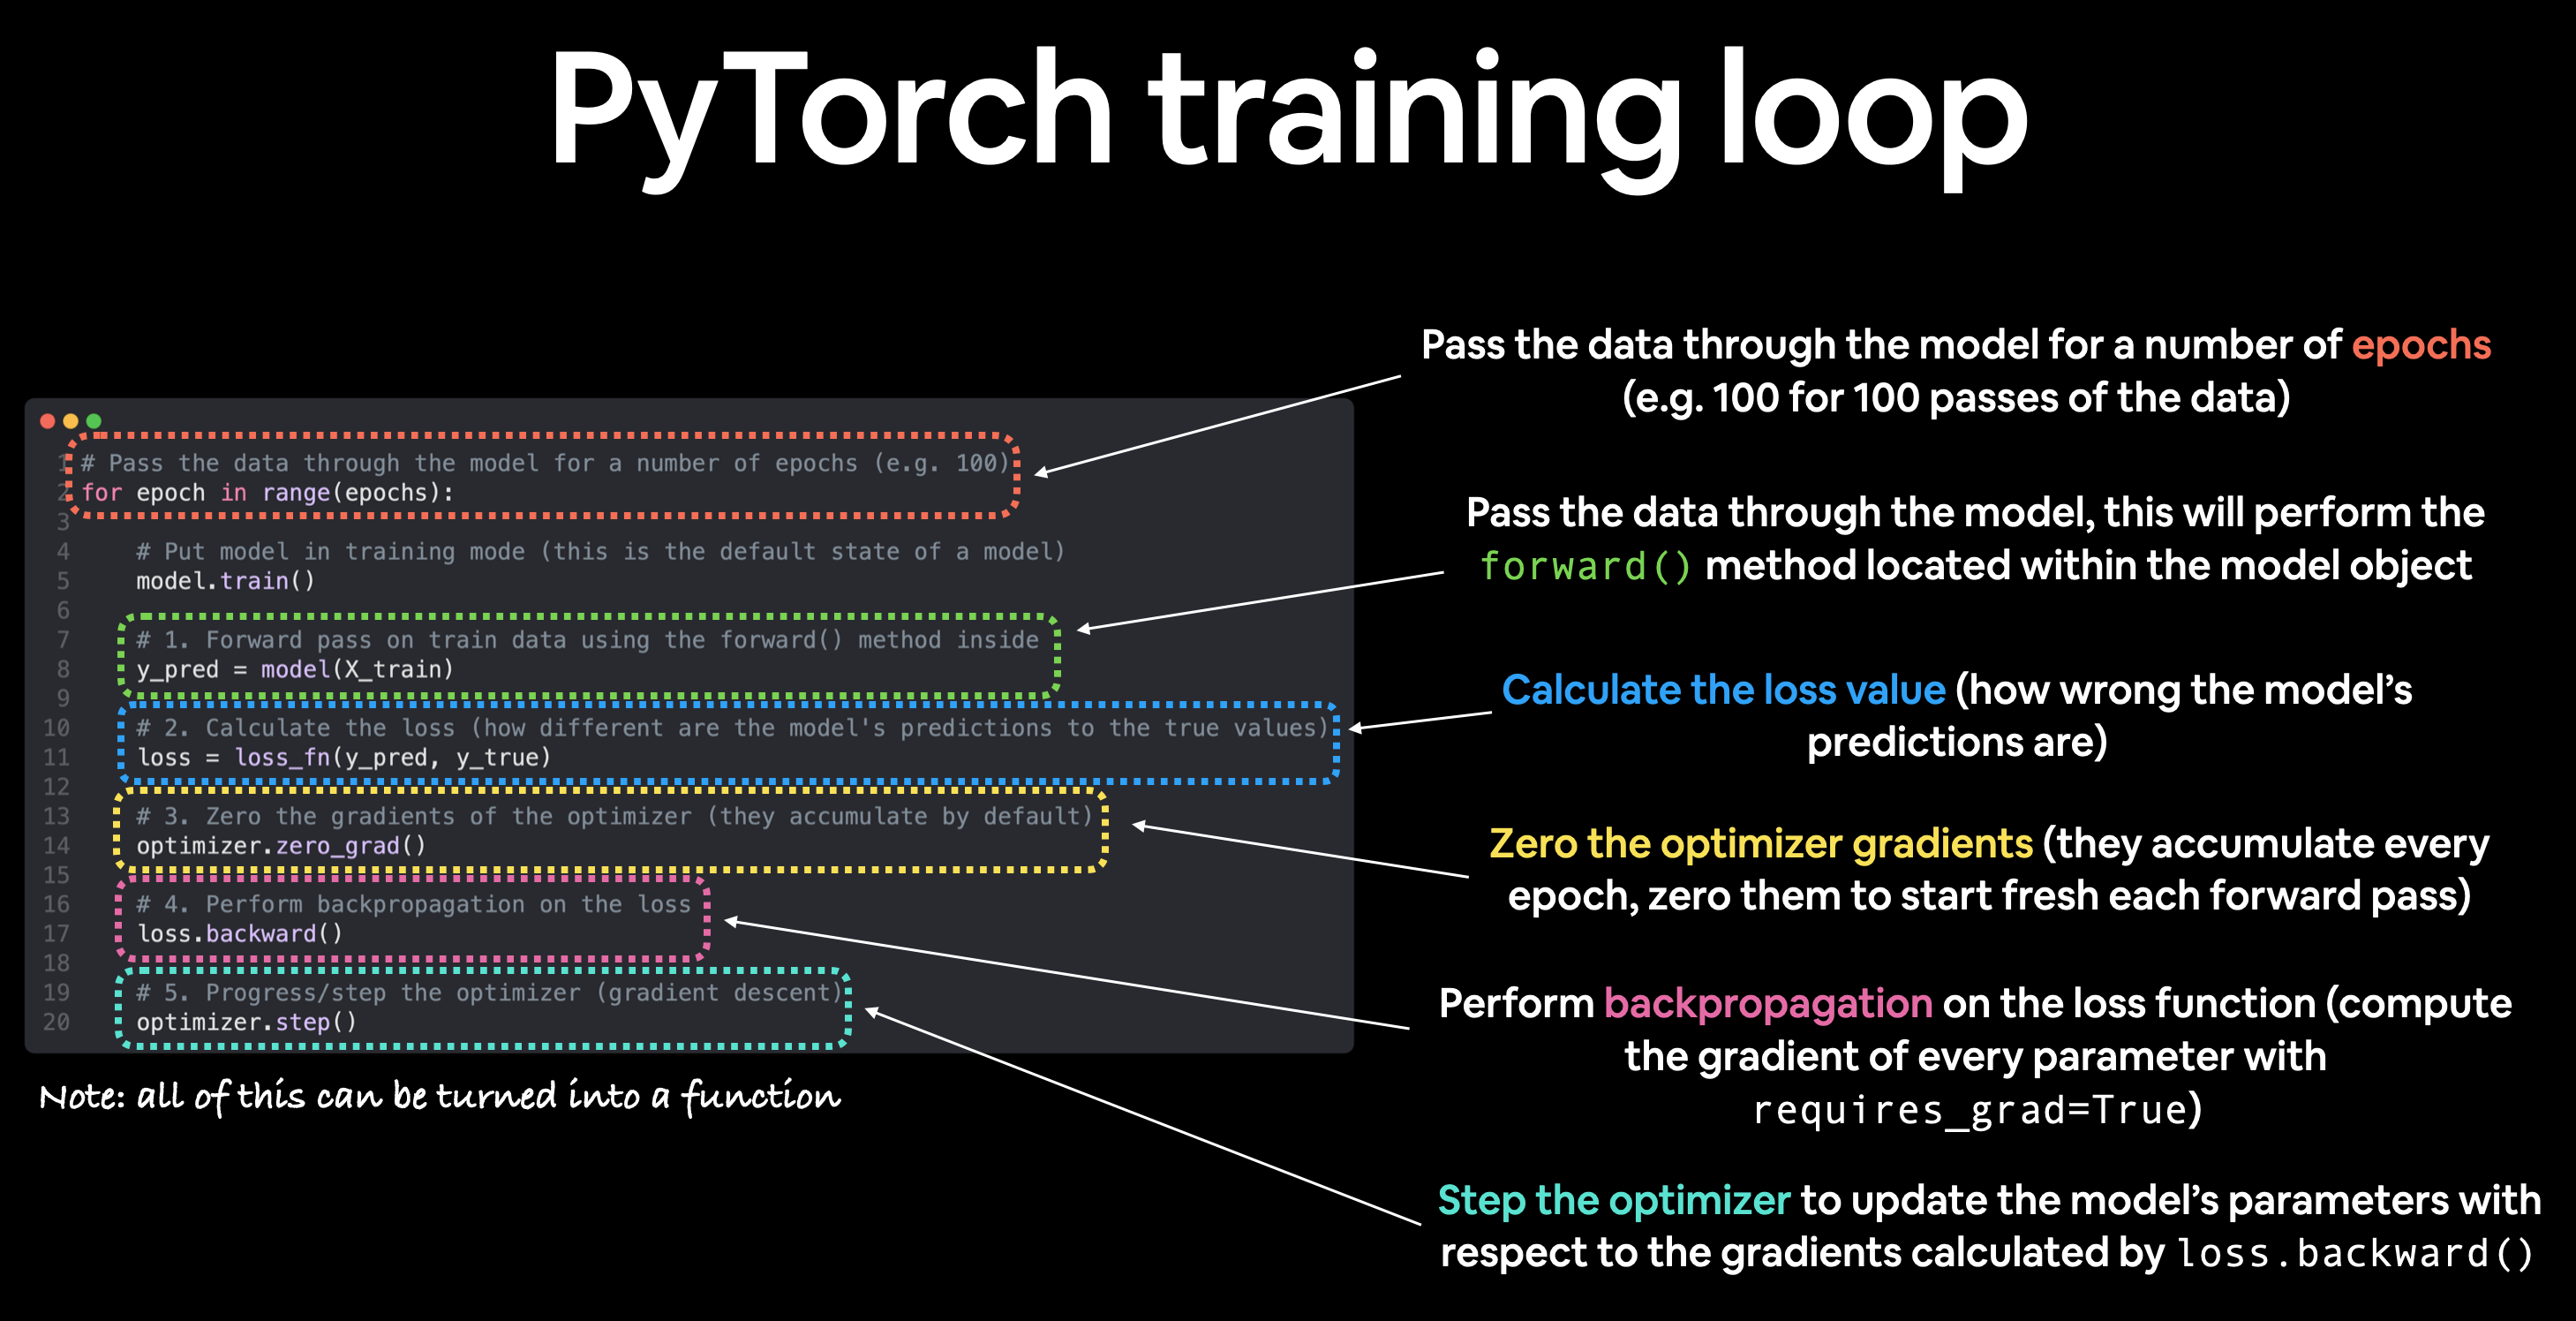
Gambar 1. Operasi yang diulang selama pelatihan. Gambar: Daniel Bourke, Learn PyTorch: Workflow Fundamentals, Lisensi MIT.
Kode kita mengosongkan gradien sebelum forward pass, bukan setelah penghitungan loss seperti pada diagram. Keduanya menghapus gradien sebelumnya sebelum backpropagation. Pada pelatihan mini-batch, operasi ini diulang untuk setiap batch dalam satu epoch.
best_f1 = -1.0

for epoch in range(4):
    model.train()
    total_loss, examples = 0.0, 0

    for batch in train_loader:
        batch = {key: value.to(device) for key, value in batch.items()}
        optimizer.zero_grad(set_to_none=True)
        loss = model(**batch).loss
        loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
        optimizer.step()

        size = batch["labels"].size(0)
        total_loss += loss.item() * size
        examples += size

    actual, predicted = predict(model, val_loader)
    score = f1_score(
        actual, predicted, labels=[0, 1, 2],
        average="macro", zero_division=0,
    )
    print(f"Epoch {epoch + 1}: loss={total_loss / examples:.4f}, val_f1={score:.4f}")

    if score > best_f1:
        best_f1 = score
        model.save_pretrained("indobertweet-sentiment")
        tokenizer.save_pretrained("indobertweet-sentiment")
Contoh ini memakai full fine-tuning standar: semua parameter model dapat berubah. Learning rate dibuat konstan, sedangkan mixed precision dan penjadwalan tidak digunakan agar alur dasarnya lebih mudah diikuti. GPU akan mempercepat pelatihan; kecilkan batch size jika memori tidak mencukupi.
5. Evaluasi checkpoint yang disimpan
Muat kembali checkpoint dengan hasil validasi terbaik, alih-alih langsung memakai hasil epoch terakhir:
best_model = AutoModelForSequenceClassification.from_pretrained(
    "indobertweet-sentiment",
).to(device)
actual, predicted = predict(best_model, test_loader)

print(classification_report(
    actual, predicted, labels=[0, 1, 2],
    target_names=[id2label[i] for i in range(3)], zero_division=0,
))
Perhatikan hasil setiap kelas, bukan hanya skor keseluruhan. Macro-F1 memberi bobot sama pada setiap kelas, sedangkan weighted F1 memperhitungkan frekuensi kelas. Periksa contoh yang salah diklasifikasikan untuk memahami apa yang belum ditangkap model.
Gunakan data validasi untuk pemilihan model dan simpan test set untuk evaluasi akhir. Eksperimen berikutnya bisa mencoba beberapa learning rate, tetapi itu layak menjadi tutorial tersendiri. Untuk sekarang, kita sudah memiliki pipeline inti: teks berlabel, batch hasil tokenisasi, training loop, dan model klasifikasi yang tersimpan.
Ucapan terima kasih
Tutorial ini berawal dari project Kerja Praktik saya selama studi sarjana di Institut Teknologi Sepuluh Nopember (ITS), saat saya mengeksplorasi model transformer dan strategi fine-tuning untuk analisis sentimen bahasa Indonesia. Terima kasih kepada Dr. Ratih Nur Esti Anggraini atas bimbingan dan dukungannya selama project ini.