Mengapa Evaluasi RAG Sulit
- Evaluation
- RAG
- LLM Systems
- Information Retrieval
Sistem retrieval-augmented generation dapat menghasilkan jawaban benar dengan alasan salah, jawaban salah dari bukti yang tepat, atau jawaban yang sepenuhnya didukung bukti tetapi menjawab pertanyaan yang keliru. Ketiganya dapat sama-sama terdengar fasih. Itulah mengapa mengevaluasi RAG lebih sulit daripada memeriksa apakah kalimat akhirnya mirip jawaban acuan.
Kesalahan utamanya adalah memperlakukan RAG sebagai satu model. RAG merupakan rangkaian sebab-akibat: korpus dipilih, dokumen dipecah, query ditafsirkan, bukti diambil dan diperingkat, konteks dimasukkan ke prompt, LLM menghasilkan klaim, dan sitasi ditambahkan. Kegagalan pada satu mata rantai mengubah jawaban. Satu skor gabungan dapat menunjukkan sistem gagal, tetapi biasanya tidak menjelaskan mengapa.
Tulisan ini menyusun peta evaluasi praktis dari penelitian primer, termasuk RAGAS, ARES, RAGChecker, RAGTruth, ALCE, RGB, dan Lost in the Middle. Ada pula contoh evaluasi kepatuhan regulasi untuk menunjukkan, melalui perhitungan konkret, mengapa dua sistem dengan akurasi jawaban sama dapat memiliki keandalan yang sangat berbeda.
RAG adalah pipeline, bukan satu model
Formulasi awal RAG menggabungkan memori parametrik model sequence-to-sequence dengan memori nonparametrik berupa indeks dokumen yang diambil (Lewis dkk., 2020). Sistem produksi modern memiliki lebih banyak komponen:
Di sini, adalah query, korpus yang tersedia, kumpulan chunk, hasil retrieval top-, operasi pemeringkatan ulang dan penyusunan konteks, konteks prompt akhir, jawaban yang dihasilkan, dan sitasi atau atribusinya.
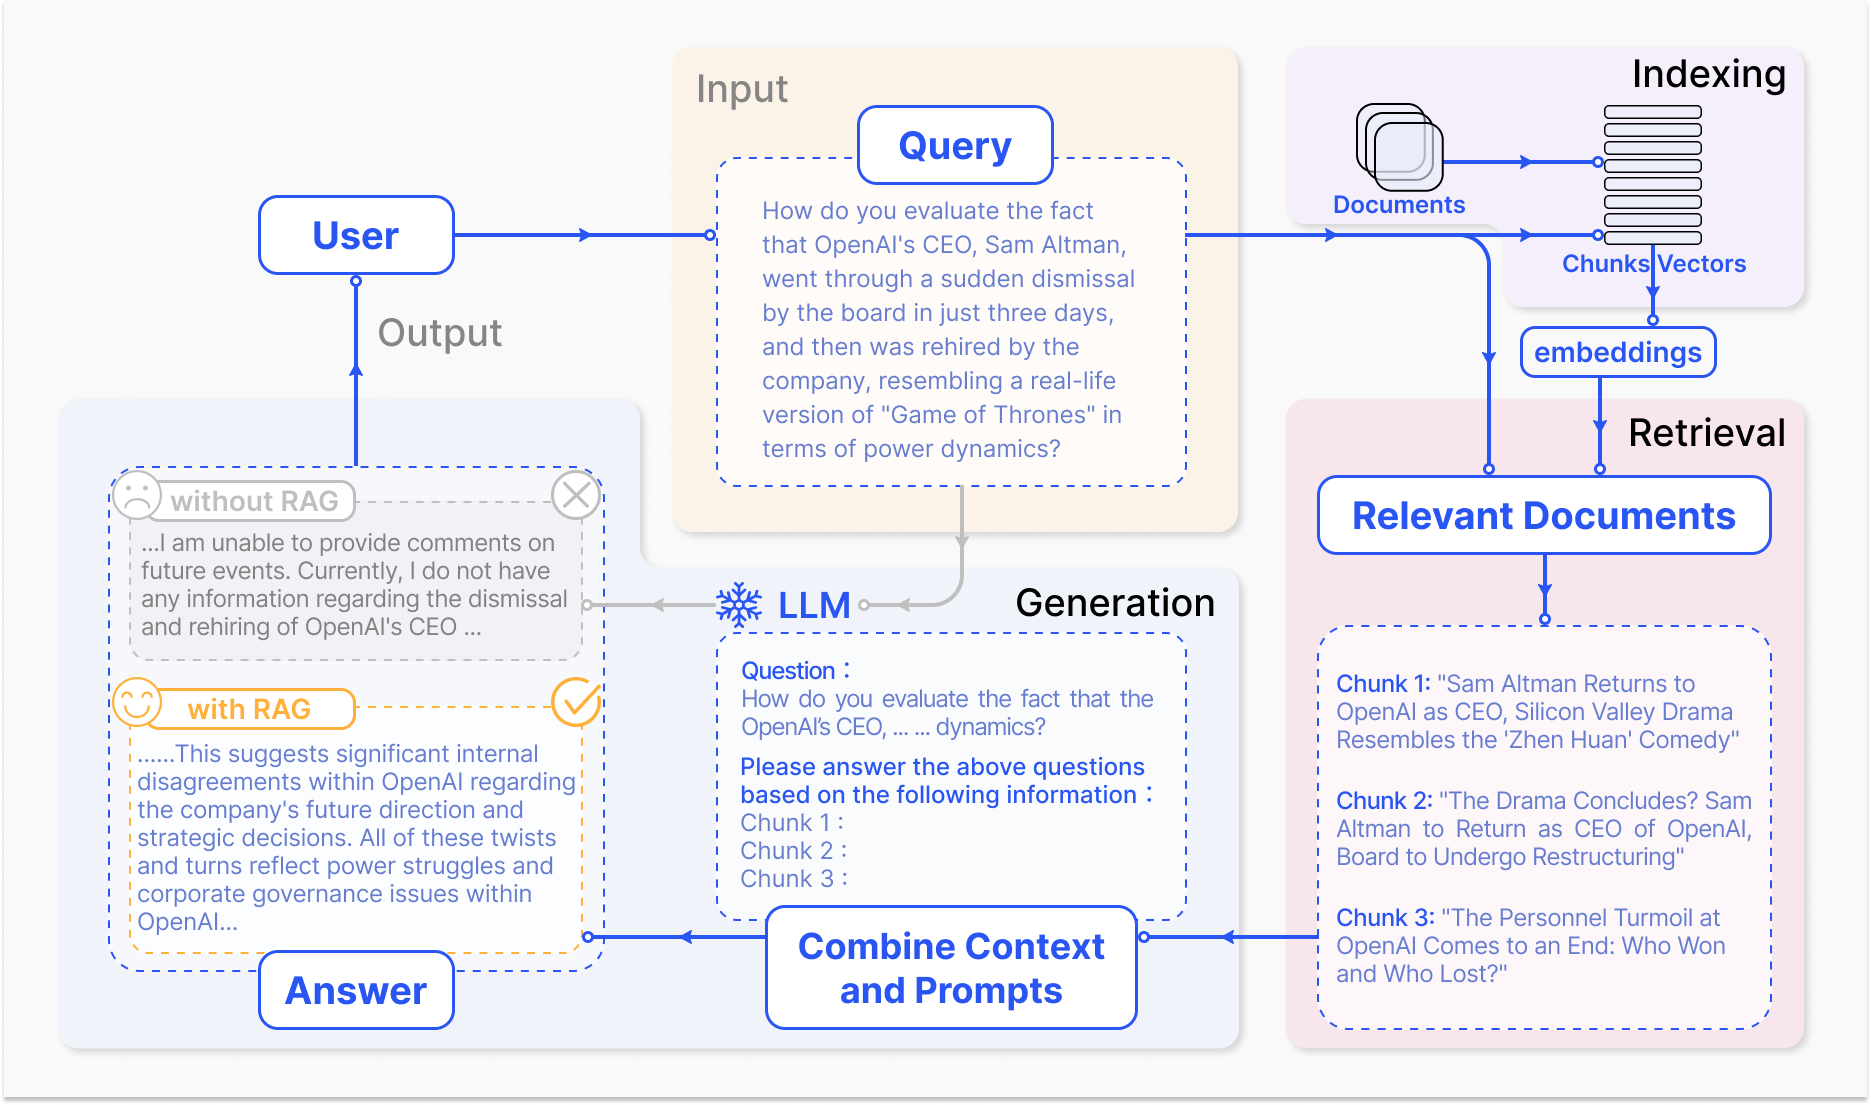
Gambar 1. Pengindeksan, retrieval, dan generasi dalam pipeline tanya-jawab RAG. Direproduksi dari Gambar 2 Gao dkk., Retrieval-Augmented Generation for Large Language Models: A Survey. Jenis kegagalan di bawah menguraikan tahap-tahap ini lebih lanjut.
| Lapisan | Contoh kegagalan | Yang tidak dapat diungkap jawaban akhir |
|---|---|---|
| Korpus | Regulasi terkini tidak pernah diindeks | Apakah retrieval memiliki peluang berhasil |
| Chunking | Aturan dan pengecualiannya terpisah | Apakah dokumen sumber memuat kedua fakta |
| Retrieval | Teks bertopik serupa tetapi tidak menjawab mengungguli aturan | Apakah kemiripan semantik sesuai kegunaan jawaban |
| Reranking | Bukti benar berada di bawah batas konteks | Apakah retrieval tahap awal sudah berhasil |
| Penyusunan konteks | Bukti benar terkubur di antara pengalih perhatian | Apakah LLM dapat memanfaatkan jendela konteksnya |
| Generasi | Model mengabaikan pengecualian yang diambil | Apakah error berasal dari retrieval atau penalaran |
| Sitasi | Dokumen yang dikutip relevan tetapi tidak mendukung klaim | Apakah jawaban dapat diverifikasi |
| Abstensi | Korpus tidak memiliki jawaban, tetapi model menebak | Apakah sistem mengenali bukti yang tidak cukup |
Modularitas ini menimbulkan persoalan penentuan penyebab. Misalkan respons salah. Jika bukti yang diperlukan tidak ada di , mengganti generator tidak menyelesaikannya. Jika bukti ditemukan tetapi diabaikan, menyetel retriever mungkin meningkatkan Recall@k tanpa memperbaiki error yang dilihat pengguna. Karena itu, evaluasi harus melayani dua pihak:
- Pengguna memerlukan ukuran menyeluruh: apakah sistem menyelesaikan tugas dengan aman dan benar?
- Pengembang memerlukan ukuran diagnostik: komponen mana yang menyebabkan error dan perubahan apa yang mungkin memperbaikinya?
RAGChecker memformalkan pembedaan ini melalui metrik keseluruhan, retriever, dan generator yang dihitung pada tingkat klaim (Ru dkk., 2024).
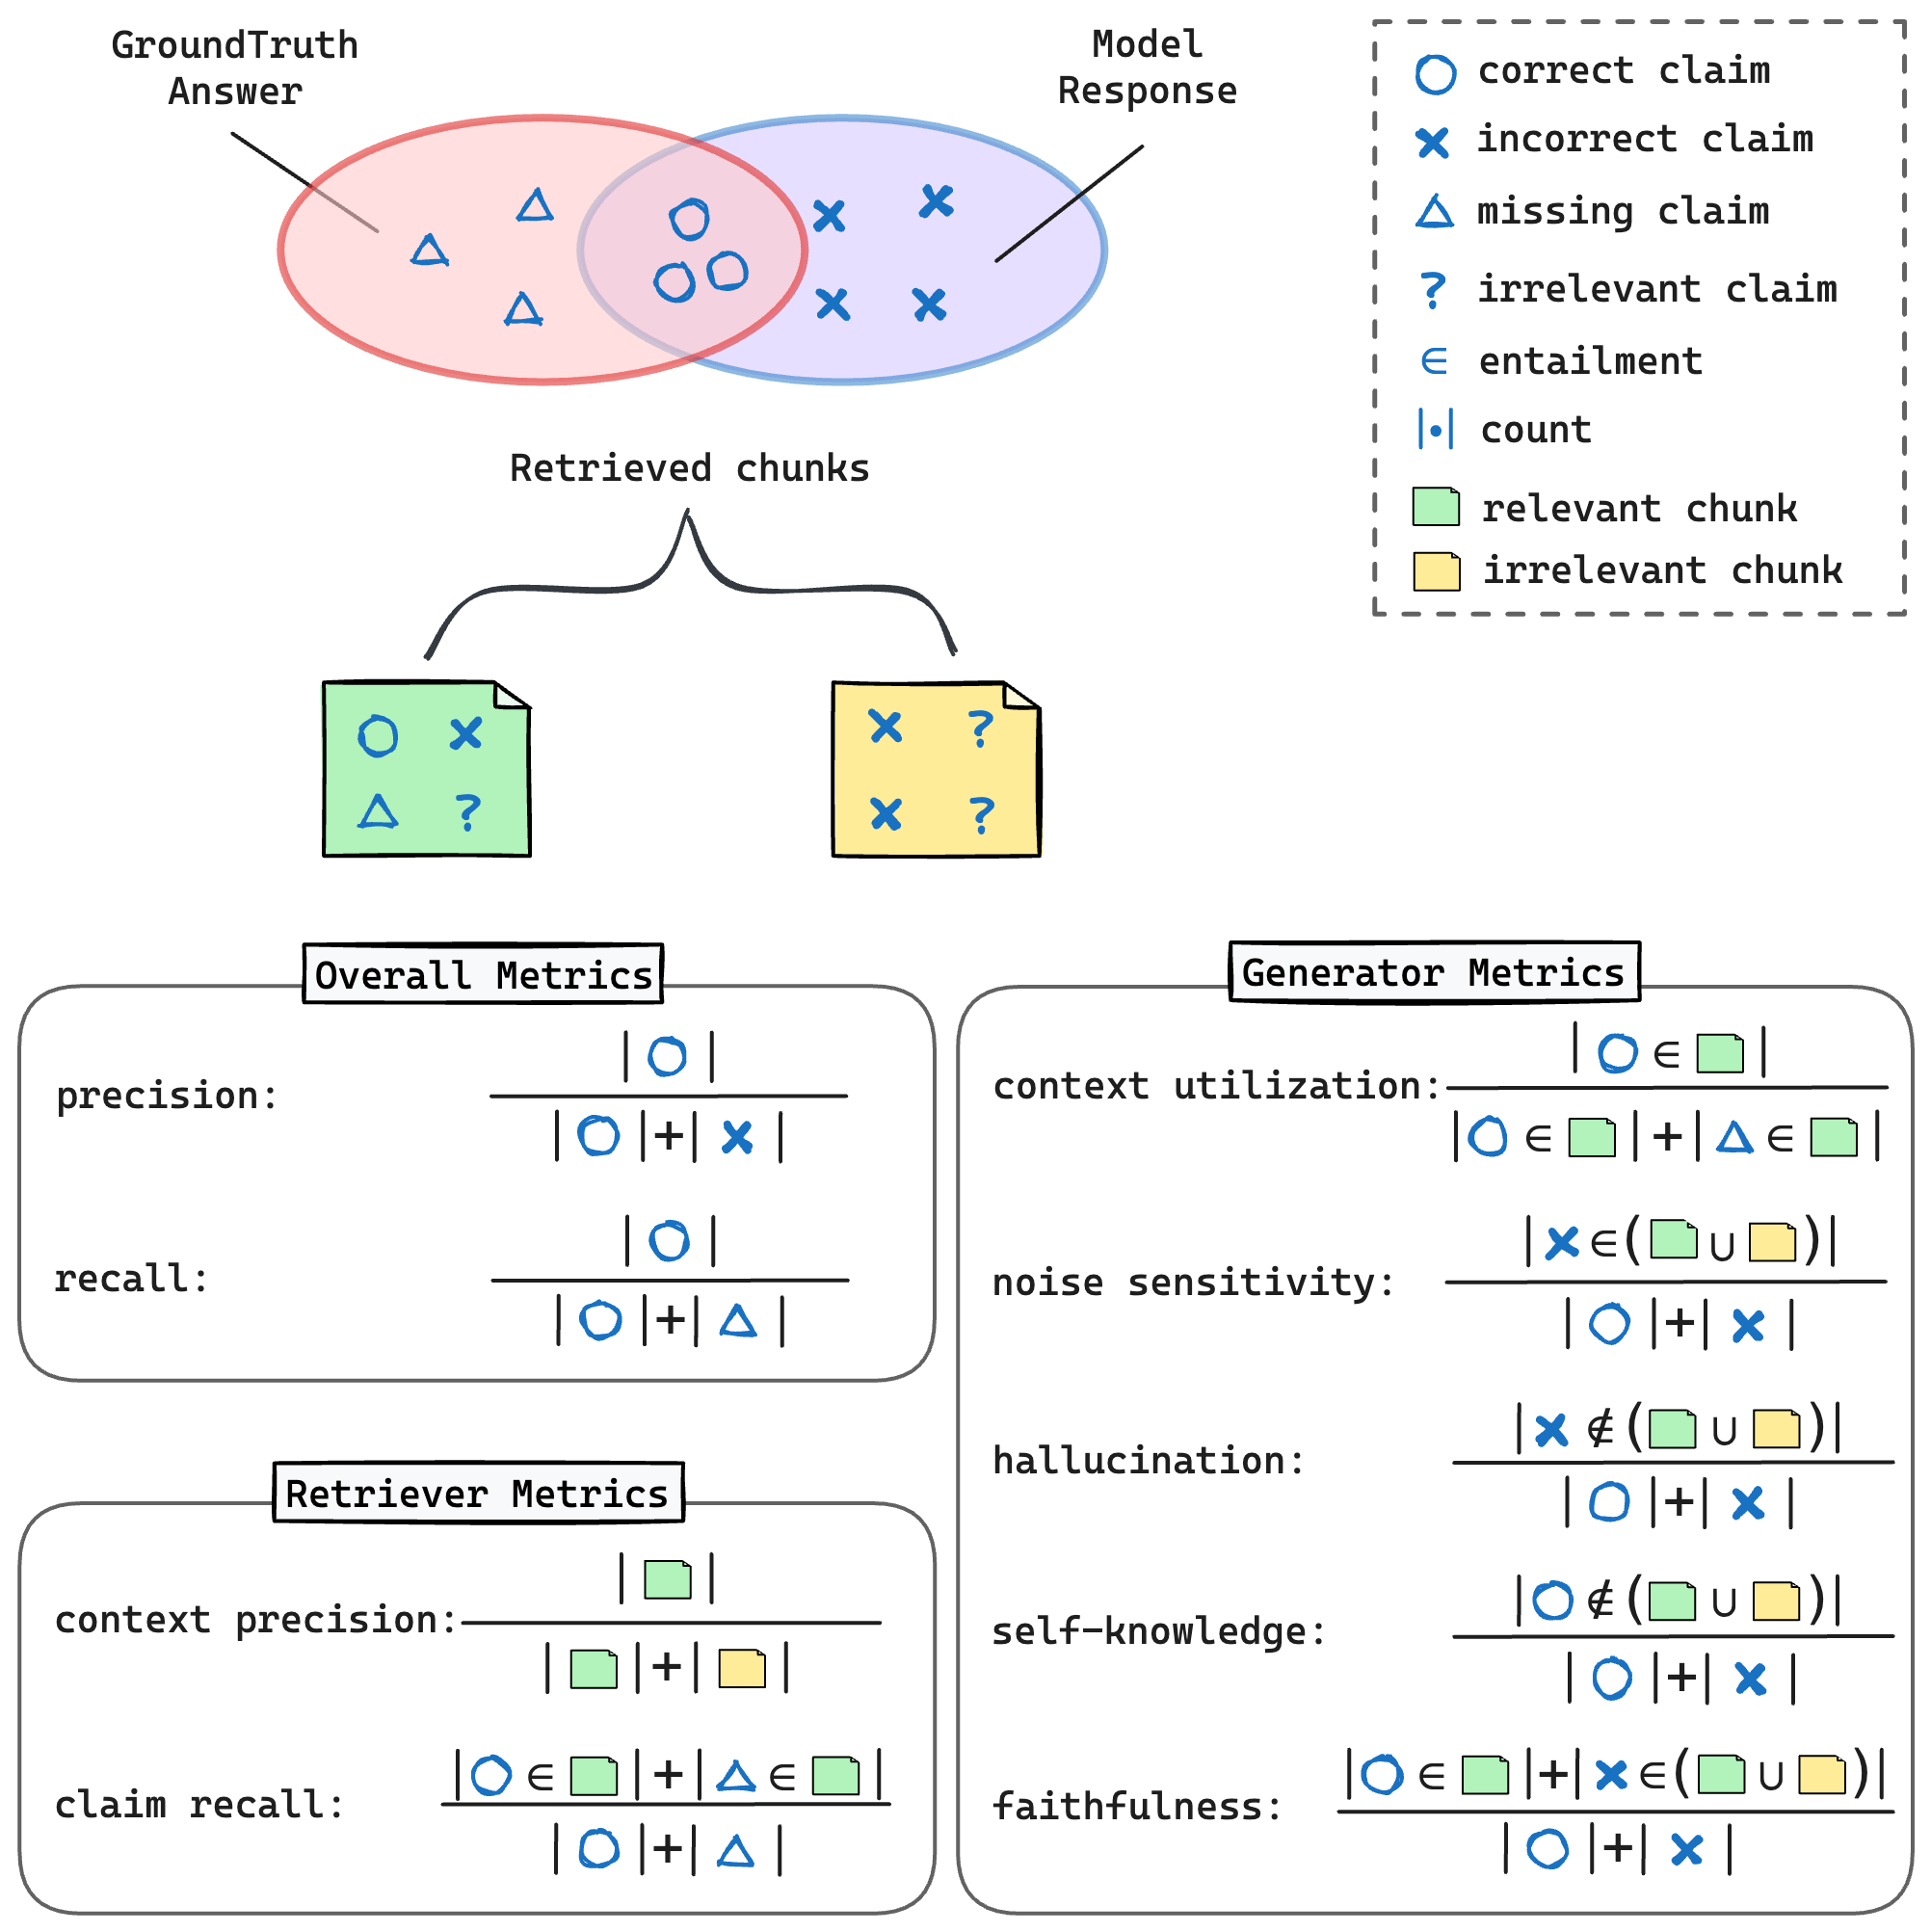
Gambar 2. Penguraian kualitas keseluruhan, retriever, dan generator pada tingkat klaim dalam RAGChecker. Gambar: Ru dkk. (2024), RAGChecker, CC BY 4.0.
Satu skor kebenaran menyembunyikan kegagalan berbeda
Pertimbangkan pertanyaan: “Berapa lama log transaksi harus disimpan menurut kebijakan saat ini, dan pengecualian apa yang memungkinkan penghapusan lebih awal?” Anggap jawaban acuan lengkap terdiri dari dua klaim atomik:
- Log transaksi pada umumnya harus disimpan selama lima tahun.
- Penghapusan lebih awal hanya diizinkan setelah pelepasan legal hold yang disetujui dan adanya otorisasi terdokumentasi.
Sekarang bandingkan empat output:
| Output | Tampak masuk akal? | Benar? | Setia pada konteks? | Lengkap? |
|---|---|---|---|---|
| “Lima tahun.” Konteks yang diambil memuat kedua klaim. | Ya | Sebagian | Ya | Tidak |
| “Lima tahun, dengan penghapusan lebih awal setelah persetujuan manajer.” Konteks menyebut pelepasan legal hold, bukan persetujuan manajer. | Ya | Tidak | Tidak | Tidak |
| Kedua klaim acuan dihasilkan dari ingatan model setelah retrieval melewatkan kebijakan | Ya | Ya | Tidak | Ya |
| “Sumber yang tersedia tidak menetapkan periode retensi.” Tidak ada kebijakan otoritatif yang diindeks. | Berhati-hati | Perilaku benar | Ya | N/A |
Metrik exact match mungkin menggagalkan output pertama, kedua, dan keempat, tetapi meloloskan yang ketiga. Padahal output ketiga berbahaya dalam sistem berbasis sumber: jawabannya kebetulan benar, tetapi jalur retrieval tidak dapat membenarkannya dan bisa gagal begitu kebijakan berubah. Sebaliknya, respons keempat bukan jawaban gagal, melainkan abstensi yang tepat.
Karena itu, beberapa definisi perlu dipisahkan:
- Kebenaran jawaban: apakah klaim benar menurut jawaban yang diterima untuk tugas tersebut?
- Faithfulness atau groundedness: apakah setiap klaim dapat disimpulkan dari konteks yang ditemukan?
- Relevansi jawaban: apakah respons benar-benar menjawab query tanpa materi tidak relevan?
- Kelengkapan: apakah respons mencakup seluruh klaim yang dibutuhkan query?
- Relevansi konteks: seberapa banyak konteks yang diambil berguna untuk menjawab query?
- Ketepatan sitasi: apakah sumber yang dikutip mendukung klaim yang terkait dengannya?
- Kelengkapan sitasi: apakah setiap klaim yang dapat diverifikasi eksternal memiliki bukti?
- Ketepatan abstensi: apakah sistem menolak menjawab ketika korpus tidak mendukung jawaban, tetapi menjawab ketika mendukung?
Kebenaran dan faithfulness sengaja dibedakan. Jawaban bisa benar tetapi tidak didukung konteks, atau secara setia mengulang dokumen palsu, kedaluwarsa, maupun berbahaya. RAG tidak mengubah teks hasil retrieval menjadi kebenaran. RAG mengubah asal-usul hasil generasi.
Mengevaluasi retrieval
Metrik pencarian informasi klasik tetap berguna jika kita memahami apa yang diukur. Misalkan adalah himpunan chunk relevan acuan untuk query , dan adalah chunk hasil retrieval top-.
Mean Reciprocal Rank memberi nilai lebih jika hasil relevan pertama berada di urutan awal:
Normalized Discounted Cumulative Gain lebih sesuai ketika relevansi bertingkat, bukan biner:
Metrik ini berguna untuk membandingkan retriever pada benchmark tetap. Dense Passage Retrieval, misalnya, melaporkan kenaikan 9–19 poin persentase atas baseline BM25 yang kuat dalam akurasi retrieval passage top-20 pada beberapa dataset tanya-jawab domain terbuka (Karpukhin dkk., 2020). Ini bukti nyata pentingnya model retrieval. Namun, aplikasi RAG menghadirkan kerumitan yang sering tidak terlihat dalam benchmark retrieval passage.
Chunk acuan tidak sama dengan bukti acuan
Label chunk bergantung pada keputusan preprocessing tertentu. Mengubah chunk 300 token menjadi dua chunk 150 token mengubah identitas “dokumen relevan”, meskipun buktinya tetap sama. RAGChecker secara eksplisit mengkritik ketergantungan Recall@k dan MRR pada anotasi chunk dan skema pemotongan yang kaku.
Evaluasi tingkat bukti lebih stabil. Uraikan jawaban acuan menjadi klaim atomik . Claim recall retriever menanyakan berapa banyak klaim yang diperlukan didukung setidaknya satu chunk hasil retrieval:
RAGChecker mendefinisikan chunk hasil retrieval sebagai relevan jika mendukung sedikitnya satu klaim acuan. Context precision-nya adalah:
Ini menjawab dua pertanyaan yang lebih berguna: apakah retrieval mencakup fakta yang diperlukan untuk menjawab, dan seberapa banyak materi pengalih perhatian ikut terbawa?
Relevansi bukan kegunaan
Potongan teks bisa relevan secara topik tetapi tidak menjawab pertanyaan. Dalam contoh retensi, chunk tentang sejarah kebijakan pencatatan transaksi mirip secara semantik dengan query, tetapi tidak menetapkan durasi terkini. Potongan berisi “lima tahun” juga bisa merujuk pada catatan identitas pelanggan, bukan log transaksi. Kemiripan dense melihat makna yang tumpang tindih; evaluasi harus memeriksa apakah potongan tersebut mendukung klaim yang diperlukan.
Masalah sebaliknya juga terjadi. Potongan yang tidak dianotasi mungkin merupakan sumber alternatif yang valid. Menganggap chunk acuan awal sebagai satu-satunya hasil yang dapat diterima menciptakan error retrieval semu. Benchmark yang dapat dipertanggungjawabkan menyimpan rentang bukti dan sumber alternatif yang diterima, bukan hanya satu ID dokumen.
Konteks lebih banyak menukar recall dengan noise
RAGChecker menyediakan bukti konkret tentang trade-off ini. Ketika jumlah chunk hasil retrieval meningkat dari 5 menjadi 20, claim recall naik dari 61,5 ke 77,6 dan faithfulness generator dari 88,1 ke 92,2. Namun, sensitivitas terhadap noise juga meningkat dari 34,0 ke 35,4, sedangkan F1 keseluruhan hanya berubah dari 51,7 ke 53,4 (Ru dkk., 2024).
Karena itu, “naikkan ” bukan peningkatan tanpa biaya. Ia memperluas peluang hadirnya klaim benar sekaligus klaim menyesatkan. Nilai optimal bergantung pada model pembaca, anggaran konteks, kualitas reranking, dan biaya tiap jenis kesalahan.
Mengevaluasi generasi pada tingkat klaim
BLEU dan ROUGE membandingkan kemiripan permukaan dengan jawaban acuan. Keduanya dapat menghukum parafrasa yang benar dan memberi nilai tinggi pada jawaban fasih yang menyalin acuan tetapi mengaitkannya dengan sumber salah. BERTScore meningkatkan pencocokan semantik melalui embedding kontekstual (Zhang dkk., 2020), tetapi kemiripan tingkat respons tetap menyembunyikan klaim mana yang didukung.
Karena itu, evaluasi teks panjang terbantu oleh klaim atomik. Misalkan adalah klaim yang diekstrak dari respons model dan klaim jawaban acuan. Jika menyatakan dukungan semantik, precision dan recall klaim adalah:
Faithfulness membandingkan klaim respons dengan konteks hasil retrieval :
RAGAS memperkenalkan strategi terkait tanpa jawaban acuan: pecah jawaban menjadi pernyataan, tanyakan kepada LLM apakah masing-masing dapat disimpulkan dari konteks, lalu hitung proporsi yang didukung (Es dkk., 2023/2025). Pada WikiEval, RAGAS melaporkan kesepakatan berpasangan dengan preferensi manusia sebesar 0,95 untuk faithfulness, 0,78 untuk relevansi jawaban, dan 0,70 untuk relevansi konteks. Relevansi konteks merupakan dimensi tersulit, terutama pada konteks panjang.
RAGChecker melangkah lebih jauh dengan memisahkan tiga sumber klaim respons yang salah:
- Sensitivitas noise relevan: generator menyalin klaim salah dari chunk yang juga mengandung bukti berguna.
- Sensitivitas noise tidak relevan: generator menyalin klaim salah dari chunk tidak relevan.
- Halusinasi: generator menghasilkan klaim salah yang tidak muncul dalam chunk mana pun.
Pembedaan ini memberi arah tindakan. Halusinasi mengarah pada perbaikan generasi atau prompting. Sensitivitas terhadap noise tidak relevan mengarah pada precision retrieval atau penyaringan konteks yang lebih kuat. Sensitivitas noise relevan mengarah pada chunking lebih rinci, ekstraksi bukti, atau generator yang dapat membedakan rentang bukti dari noise di sekitarnya.
Dua diagnostik lain juga penting:
- Pemanfaatan konteks: dari klaim acuan yang tersedia dalam konteks retrieval, berapa banyak yang benar-benar dipakai generator?
- Ketergantungan pada pengetahuan internal: berapa banyak klaim respons benar tidak didukung konteks retrieval dan berasal dari memori parametrik?
Sistem bisa sangat setia pada konteks tetapi tetap tidak lengkap karena hanya menggunakan satu dari tiga fakta yang tersedia. Faithfulness tidak menggantikan pemanfaatan konteks atau recall.
Kualitas sitasi memiliki target tersendiri
Menambahkan [1] setelah kalimat tidak membuat kalimat itu otomatis didukung. Evaluasi sitasi memiliki sedikitnya dua dimensi:
ALCE mengevaluasi kefasihan, kebenaran, dan kualitas sitasi sistem secara menyeluruh. Penulisnya menemukan bahwa pada dataset ELI5, bahkan model terbaik yang dievaluasi tidak memiliki dukungan sitasi lengkap pada sekitar 50% kasus (Gao dkk., 2023). Ini menunjukkan kualitas jawaban dan kualitas atribusi tidak otomatis meningkat bersama.
Pertimbangkan klaim: “Log harus disimpan selama lima tahun kecuali pelepasan legal hold mengizinkan penghapusan [1].” Sitasi [1] mungkin:
- menetapkan lima tahun tetapi tidak membahas pengecualian;
- menjelaskan pengecualian tetapi berlaku untuk kebijakan yang sudah diganti;
- relevan secara topik tanpa memuat kedua persyaratan;
- mendukung kedua bagian, tetapi hanya dalam tabel yang dibuang pipeline ekstraksi.
Evaluasi sebaiknya memisahkan klaim majemuk sebelum memeriksa dukungan semantik, serta mencatat versi dokumen, tanggal berlaku, dan rentang bukti tepat. Dalam sistem regulasi, sitasi aturan kedaluwarsa bukan sekadar relevansi rendah; ia dapat memuat fakta yang dilarang digunakan.
Jendela konteks panjang tidak menjamin konteks dipakai
Studi Lost in the Middle mengendalikan posisi dokumen yang memuat jawaban sambil mempertahankan pertanyaan, dokumen, dan jawaban yang diharapkan. Performa mengikuti kurva U: model lebih baik memakai bukti di awal atau akhir, dan lebih buruk di tengah (Liu dkk., 2023).
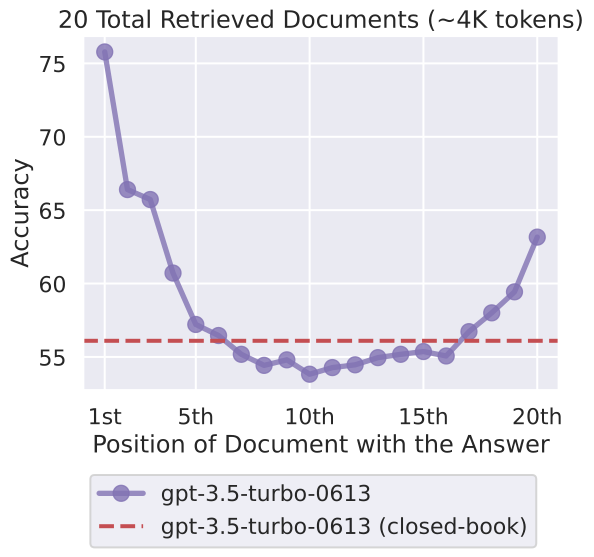
Gambar 3. Performa model berubah menurut posisi informasi relevan dalam konteks input. Direproduksi dari Gambar 1 Liu dkk., Lost in the Middle: How Language Models Use Long Contexts (pracetak 2023; diterbitkan di TACL, 2024).
Desain terkontrol ini penting: mengurutkan ulang pengalih perhatian tidak mengubah jawaban benar, sehingga perubahan performa mengisolasi posisi konteks sebagai penyebab. Paper melaporkan penurunan GPT-3.5-Turbo lebih dari 20 poin persentase; pada sebagian pengaturan 20 dan 30 dokumen, performa saat jawaban di tengah bahkan di bawah akurasi closed-book 56,1%. Varian berkonteks lebih panjang belum tentu lebih baik menggunakan konteks yang muat di kedua jendela.
Tambahan dokumen juga memperlihatkan manfaat yang makin kecil. Di NaturalQuestions-Open, peningkatan dari 20 menjadi 50 dokumen hanya menambah akurasi jawaban sekitar 1,5% untuk GPT-3.5-Turbo dan 1% untuk Claude-1.3, meskipun recall retriever terus naik. Pembaca mencapai kejenuhan lebih awal daripada retriever.
Ini menghasilkan dua kebutuhan evaluasi yang tidak terlihat dari rata-rata Recall@k:
- Acak atau variasikan secara sistematis posisi bukti pendukung dalam prompt.
- Plot kualitas jawaban, cakupan retrieval, latensi, dan biaya token secara bersamaan ketika dan ukuran chunk berubah.
Uji ketahanan yang terlewat oleh rata-rata QA
Benchmark RGB menguraikan perilaku pembaca RAG menjadi empat kemampuan (Chen dkk., 2023/2024):
- Ketahanan terhadap noise: memakai bukti benar meskipun ada konteks tidak relevan.
- Penolakan saat bukti tidak ada: tidak menjawab ketika tidak tersedia bukti pendukung.
- Integrasi informasi: menggabungkan fakta yang tersebar antardokumen.
- Ketahanan kontrafaktual: menolak informasi salah hasil retrieval yang bertentangan dengan pengetahuan benar.
Evaluasi enam LLM mereka menemukan sebagian ketahanan terhadap noise, tetapi kesulitan besar pada penolakan, integrasi antardokumen, dan informasi salah. RAGTruth secara terpisah menegaskan bahwa retrieval tidak menghilangkan halusinasi: korpusnya berisi hampir 18.000 respons RAG yang dihasilkan secara alami, dianotasi manual pada tingkat kasus dan kata untuk konten tanpa dukungan atau bertentangan (Niu dkk., 2024).
Kumpulan uji tekanan praktis sebaiknya juga mencakup:
| Kelompok uji | Yang diungkap |
|---|---|
| Query tanpa jawaban | Apakah sistem menebak alih-alih abstain |
| Dokumen terkini dan yang sudah diganti | Penalaran waktu dan otoritas sumber |
| Sumber bertentangan | Penanganan konflik dan asal-usul |
| Chunk hampir duplikat | Stabilitas ranking dan pemborosan konteks |
| Entitas ambigu | Resolusi entitas, bukan tumpang tindih kata |
| Relasi multi-hop | Kemampuan menggabungkan bukti tersebar |
| Chunk jawaban di tengah | Pemanfaatan konteks berdasarkan posisi |
| Prompt injection dalam hasil retrieval | Apakah teks dokumen dapat menimpa kebijakan sistem |
| Dokumen korpus hilang | Apakah evaluasi membedakan kegagalan korpus dari retriever |
LLM sebagai penilai: berguna, tetapi bukan kebenaran acuan
Evaluasi manusia mahal dan lambat, terutama jika anotator memerlukan keahlian hukum, medis, atau teknis. Penilai LLM membuat iterasi lebih praktis, tetapi menambah satu model lagi yang perilakunya juga harus dievaluasi.
RAGAS menggunakan model dengan prompt untuk memperkirakan faithfulness, relevansi jawaban, dan relevansi konteks tanpa jawaban acuan. ARES menghasilkan data sintetis sesuai domain, melakukan fine-tuning penilai ringan untuk ketiga dimensi, lalu memakai sedikit data berlabel manusia dengan prediction-powered inference untuk mengoreksi estimasi dan menghasilkan interval kepercayaan (Saad-Falcon dkk., 2024).
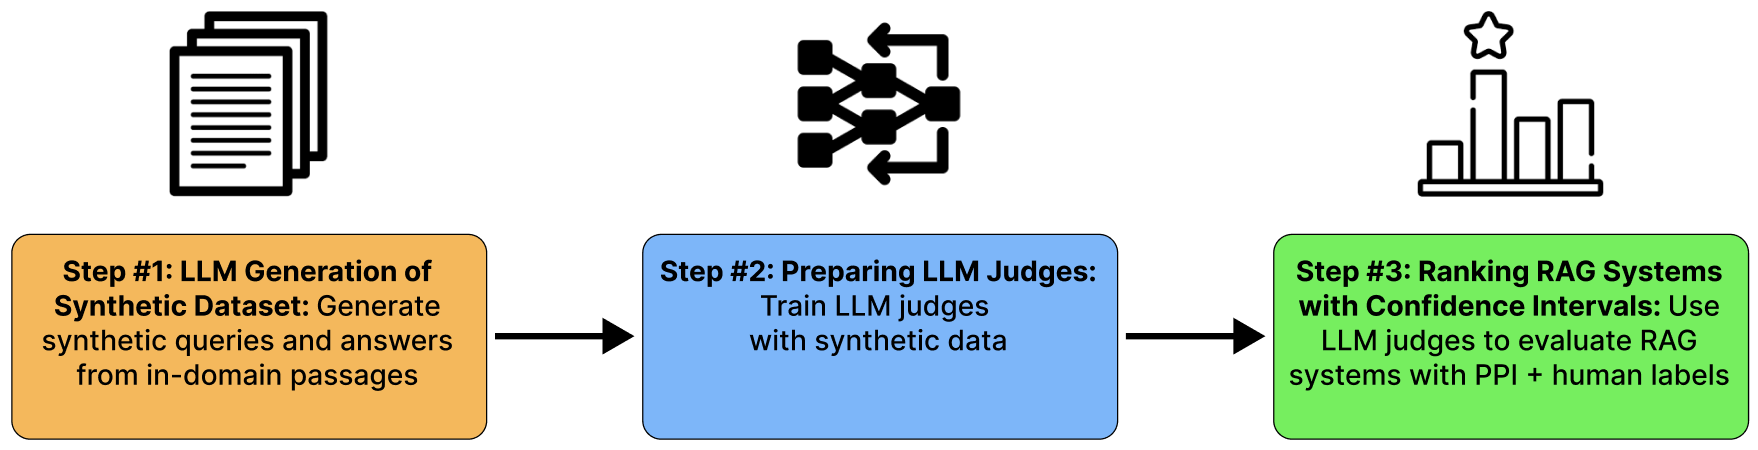
Gambar 4. ARES melatih penilai sesuai domain dari contoh sintetis, lalu mengalibrasi skor sistem dengan label manusia dan prediction-powered inference. Gambar: Saad-Falcon dkk. (2024), ARES, CC BY 4.0.
ARES melaporkan kebutuhan anotasi 78% lebih sedikit daripada baseline anotasi sampelnya, sambil menghasilkan pemeringkatan yang lebih akurat. Sekitar 150 anotasi manusia menjadi ukuran validasi minimum yang berguna pada pengaturan yang diuji. Namun, keterbatasannya penting: domain khusus tetap memerlukan anotator ahli, dan pergeseran besar seperti bahasa Inggris ke bahasa lain atau teks ke kode membutuhkan data baru sesuai domain.
RAGChecker melakukan meta-evaluasi terhadap preferensi manusia berpasangan. Untuk penilaian keseluruhan, metriknya mencapai korelasi Pearson/Spearman 0,6193/0,6090, dibanding 0,4831/0,5723 untuk baseline RAGAS terkuat dalam perbandingan tersebut. Korelasi anotator manusia masih lebih tinggi, 0,7009/0,6889. Paper menampilkan angka pada skala 0–100; di sini saya menormalkannya ke 0–1. Evaluasi otomatis membaik, tetapi belum menyamai batas manusia.
Secara lebih umum, MT-Bench menemukan penilai LLM kuat dapat melampaui 80% kesepakatan dengan preferensi manusia, kira-kira setara kesepakatan antarmanusia dalam pengaturannya. Penelitian yang sama mendokumentasikan bias posisi, kepanjangan jawaban, dan mengunggulkan diri sendiri (Zheng dkk., 2023). Karena itu:
- tukar urutan jawaban dalam penilaian berpasangan dan ukur perubahan preferensi;
- pisahkan gaya dari ketepatan fakta dalam rubrik;
- minta bukti tingkat klaim, bukan satu skor menyeluruh;
- kalibrasikan dengan label manusia ahli domain;
- tetapkan model penilai, versi, prompt, temperature, dan pengaturan decoding;
- laporkan kesepakatan serta interval kepercayaan, bukan hanya skor penilai.
Contoh perhitungan: evaluasi RAG regulasi
Kutipan kebijakan berikut sintetis. Tujuannya memperlihatkan perilaku evaluasi, bukan menyatakan hukum yang sebenarnya.
Snapshot korpus
| ID | Status | Kutipan |
|---|---|---|
C1 | Terkini, otoritatif | “Institusi yang tercakup menyimpan log transaksi selama lima tahun sejak transaksi selesai.” |
C2 | Terkini, otoritatif | “Penghapusan lebih awal memerlukan pelepasan seluruh legal hold aktif dan otorisasi terdokumentasi dari pejabat pengelola arsip.” |
C3 | Sudah diganti | “Log transaksi wajib disimpan selama tiga tahun.” |
C4 | Terkini tetapi tidak relevan | “Catatan kontak pelanggan harus diperbaiki setelah permintaan terverifikasi.” |
C5 | Komentar, tidak otoritatif | “Banyak tim memperoleh persetujuan manajer sebelum penghapusan rutin.” |
Query: Berapa periode retensi log transaksi saat ini, dan kapan log boleh dihapus lebih awal?
Klaim acuan:
G1: Retensi normal adalah lima tahun.G2: Penghapusan lebih awal memerlukan pelepasan semua legal hold aktif.G3: Penghapusan lebih awal memerlukan otorisasi terdokumentasi dari pejabat pengelola arsip.
Klaim terlarang: retensi tiga tahun; persetujuan manajer sudah cukup; pelepasan legal hold saja sudah cukup.
Empat percobaan
| Percobaan | Top-3 hasil retrieval | Jawaban yang dihasilkan | Kegagalan utama |
|---|---|---|---|
| A | C3, C5, C4 | “Tiga tahun; persetujuan manajer mengizinkan penghapusan lebih awal.” | Retrieval memilih teks kedaluwarsa dan tidak otoritatif |
| B | C1, C2, C4 | “Lima tahun; pelepasan legal hold mengizinkan penghapusan lebih awal.” | Generator menghilangkan syarat otorisasi |
| C | C1, C2, C3 | Jawaban acuan lengkap dengan sitasi C1 dan C2 | Benar meskipun ada pengalih berbahaya |
| D | C4, C5; C1 dan C2 tidak ada dalam snapshot | “Sumber yang tersedia tidak menetapkan aturan tersebut.” | Abstensi yang tepat |
Dalam retrieval, chunk hanya relevan jika mendukung klaim acuan. Perhitungannya:
| Percobaan | Claim recall | Context precision | Alasan |
|---|---|---|---|
| A | Tidak ada klaim acuan terkini yang didukung | ||
| B | C1 dan C2 bersama-sama mencakup semua klaim | ||
| C | Cakupan sama, ditambah pengalih yang sudah diganti | ||
| D | N/A | N/A | Cakupan korpus gagal sebelum retrieval berpeluang berhasil |
Sekarang evaluasi klaim yang dihasilkan:
| Percobaan | Claim precision | Claim recall | Faithfulness | Memuat klaim terlarang | Perilaku benar? |
|---|---|---|---|---|---|
| A | Ya | Tidak | |||
| B | Ya | Tidak | |||
| C | Tidak | Ya | |||
| D | N/A | N/A | 1.00 terhadap konteks tersedia | Tidak | Ya |
Percobaan A adalah contoh tandingan penting: faithfulness sempurna, tetapi kebenaran nol. Generator secara setia mengulang hasil retrieval buruk. Percobaan B membuktikan claim recall retrieval sempurna tidak menjamin jawaban lengkap. Percobaan D menunjukkan metrik yang hanya menilai jawaban dapat menghukum perilaku paling aman saat bukti memang tidak ada.
Untuk aplikasi berisiko tinggi, tentukan syarat kelulusan menyeluruh yang ketat:
dengan himpunan klaim yang diperlukan, himpunan klaim yang dihasilkan, dan klaim terlarang atau kedaluwarsa. Untuk kasus tanpa jawaban, syarat lulus berubah menjadi abstensi yang tepat tanpa klaim substantif tak berdasar.
Susun set evaluasi sebelum memilih metrik
Kumpulan query menentukan makna skor. Pertanyaan yang dihasilkan langsung dari chunk sumber sering membocorkan kosakata sumber, terlalu banyak mewakili pencarian sederhana, dan menjamin jawaban tersedia. Akibatnya retrieval tampak lebih mudah daripada kondisi produksi.
Benchmark yang lebih kuat menggabungkan penggunaan nyata dengan kasus tekanan terkontrol. Simpan struktur yang cukup untuk mendiagnosis kegagalan:
query
corpus_snapshot_id
answerability
gold_claims
supporting_evidence_spans
acceptable_alternative_sources
forbidden_or_outdated_claims
query_type
difficulty
temporal_scope
risk_level
Kelompok uji yang disarankan mencakup pencarian langsung, sintesis, perbandingan, multi-hop, waktu, entitas ambigu, pertanyaan tanpa jawaban, hard negative, noise, dan serangan adversarial. Laporkan masing-masing secara terpisah. Sistem dapat meningkatkan F1 rata-rata melalui pertanyaan mudah sambil memburuk pada query langka berisiko tinggi yang justru menjadi alasan sistem dibangun.
Tiga mode pengujian memiliki tujuan berbeda:
- Query dari penggunaan produksi memperkirakan kegunaan nyata dan mengungkap kosakata autentik.
- Kasus buatan ahli mencakup batas keamanan, fakta terlarang, dan nuansa domain.
- Perturbasi sintetis mengisolasi faktor penyebab seperti urutan konteks, penghapusan dokumen, pertentangan, dan kemiripan hard negative.
Benchmark juga harus membekukan snapshot korpus. Mengevaluasi jawaban acuan terhadap korpus yang lebih baru atau lama diam-diam mengubah keterjawaban dan membuat perbandingan model tidak valid.
Ukur ketidakpastian, biaya, dan pergeseran
Kenaikan satu poin belum menjadi bukti jika lebih kecil daripada noise pengukuran. Evaluasi kandidat sistem pada query sama, lakukan bootstrap pada selisih skor berpasangan, lalu laporkan interval kepercayaan:
Jika interval bootstrap 95% untuk melintasi nol, eksperimen belum membuktikan B lebih baik. Ini makin penting saat penilai LLM menambah variasi prompt dan decoding. Ulangi subset kalibrasi dengan prompt atau percobaan penilai berbeda, lalu laporkan kesepakatannya.
Kualitas juga harus dilihat bersama biayanya. Untuk setiap konfigurasi, catat:
- latensi retrieval, reranking, dan generasi secara terpisah;
- token input dan output;
- biaya uang per query;
- ukuran konteks dan jumlah sumber;
- frekuensi timeout dan fallback;
- tingkat abstensi, eskalasi, koreksi, dan insiden.
Berikan versi pada korpus, chunker, model embedding, indeks, reranker, prompt, generator, dan penilai. Tanpanya, evaluasi tidak dapat direproduksi dan sumber regresi sulit ditemukan.
Matriks evaluasi praktis
| Lapisan | Metrik offline | Uji terkontrol | Sinyal produksi |
|---|---|---|---|
| Korpus | Cakupan jawaban, kebaruan | Hapus atau ganti sumber acuan | Tingkat query belum terselesaikan |
| Chunking | Rentang bukti tetap utuh | Pisahkan aturan dan pengecualian | Kegagalan pemeriksaan sumber |
| Retriever | Claim recall, context precision, NDCG | Hard negative dan query multi-hop | Pembukaan sumber dan penggunaan lanjutan |
| Reranker | Posisi bukti, NDCG | Pindahkan bukti acuan antarperingkat | Tingkat konteks berguna |
| Generator | F1 klaim, faithfulness, pemanfaatan | Konteks bertentangan dan bernoise | Koreksi dan eskalasi |
| Sitasi | Ketepatan dan kelengkapan | Sumber relevan yang tidak mendukung klaim | Pembukaan dan sengketa sitasi |
| Abstensi | Akurasi selektif, penolakan keliru | Hapus seluruh bukti jawaban | Insiden jawaban tak berdasar |
| Sistem | Tingkat kelulusan ketat, keberhasilan tugas | Benchmark menyeluruh yang dibekukan | Latensi, biaya, penyelesaian kebutuhan pengguna |
Karena itu, evaluasi minimum yang serius sebaiknya mencakup:
- Metrik tugas menyeluruh sesuai kriteria penerimaan sebenarnya.
- Cakupan retrieval tingkat klaim dan context precision.
- Kebenaran, kelengkapan, dan faithfulness klaim.
- Dukungan dan cakupan sitasi.
- Kelompok pertanyaan tanpa jawaban, bertentangan, temporal, multi-hop, dan hard negative.
- Kalibrasi manusia untuk penilai otomatis.
- Interval kepercayaan berpasangan beserta latensi dan biaya.
Hal yang perlu diingat
- Evaluasi RAG sulit karena respons akhir dihasilkan oleh rangkaian komponen yang saling berinteraksi.
- Kebenaran, faithfulness, kelengkapan, relevansi, kualitas sitasi, dan abstensi mengukur sifat berbeda; tidak ada yang aman menggantikan lainnya.
- Recall@k dan MRR berguna tetapi mewarisi asumsi batas chunk dan dokumen acuan. Bukti tingkat klaim memberi target lebih stabil.
- Konteks retrieval lebih banyak memperluas cakupan dan dapat meningkatkan faithfulness, tetapi juga menambah noise, kegagalan posisi, latensi, dan biaya.
- Jendela konteks panjang adalah kapasitas, bukan bukti pemanfaatan. Variasikan posisi bukti dan panjang konteks.
- Penilai LLM membuat iterasi memungkinkan, tetapi membutuhkan kalibrasi manusia, pemeriksaan bias, pengelolaan versi, dan estimasi ketidakpastian.
- Benchmark terbaik dimulai dari penggunaan nyata, lalu menambahkan perturbasi terkontrol yang mengungkap kegagalan yang belum terlihat dalam log produksi.
Tujuannya bukan membuat dashboard terbesar. Tujuannya menciptakan evaluasi yang membuat setiap kegagalan penting mengubah sedikitnya satu metrik, dan setiap metrik mengarahkan tindakan engineering.
Referensi
- P. Lewis et al., "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks," NeurIPS, 2020. arXiv
- V. Karpukhin et al., "Dense Passage Retrieval for Open-Domain Question Answering," EMNLP, 2020. arXiv
- S. Es, J. James, L. Espinosa-Anke, and S. Schockaert, "Ragas: Automated Evaluation of Retrieval Augmented Generation," 2023, revised 2025. arXiv
- J. Saad-Falcon, O. Khattab, C. Potts, and M. Zaharia, "ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems," NAACL, 2024. arXiv
- D. Ru et al., "RAGChecker: A Fine-grained Framework for Diagnosing Retrieval-Augmented Generation," 2024. arXiv
- J. Chen, H. Lin, X. Han, and L. Sun, "Benchmarking Large Language Models in Retrieval-Augmented Generation," AAAI, 2024. arXiv
- C. Niu et al., "RAGTruth: A Hallucination Corpus for Developing Trustworthy Retrieval-Augmented Language Models," 2024. arXiv
- T. Gao, H. Yen, J. Yu, and D. Chen, "Enabling Large Language Models to Generate Text with Citations," EMNLP, 2023. arXiv
- N. F. Liu et al., "Lost in the Middle: How Language Models Use Long Contexts," TACL, 2023. arXiv
- L. Zheng et al., "Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena," NeurIPS Datasets and Benchmarks, 2023. arXiv
- S. Min et al., "FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation," EMNLP, 2023. arXiv
- T. Zhang et al., "BERTScore: Evaluating Text Generation with BERT," ICLR, 2020. OpenReview
- C. D. Manning, P. Raghavan, and H. Schutze, Introduction to Information Retrieval. Cambridge University Press, 2008. Online
- S.-Q. Yan, J.-C. Gu, Y. Zhu, and Z.-H. Ling, "Corrective Retrieval Augmented Generation," 2024. arXiv
Sitasi
Untuk merujuk tulisan ini:
Ma'ruf, Muhammad Rifqi. "Why RAG Evaluation Is Hard." rifqimaruf.dev (2026). https://rifqimaruf.dev/writing/why-rag-evaluation-is-hard/