ReAct vs Agen dengan Tool Calling
- LLM Systems
- Agents
- MCP
Misalkan kita bertanya kepada asisten: “Tiket Project X mana yang masih terhambat, dan apa penjelasan alasannya dalam catatan rapat?” Jawaban yang berguna memerlukan lebih dari paragraf yang terdengar masuk akal. Asisten harus menemukan project yang tepat, mengambil status tiket terkini, menemukan diskusi terkait, dan membedakan penjelasan lama dari hambatan yang masih berlaku. Hasil pencarian mungkin mengungkap ID tiket yang tidak disebutkan dalam pertanyaan. Tindakan berikutnya bergantung pada hasil tindakan sebelumnya.
Dalam situasi ini, pembahasan ReAct dan agen dengan tool calling sering membingungkan. Keduanya dapat melibatkan model bahasa yang memilih tool, membaca hasil, dan menentukan langkah berikutnya. Menganggap keduanya sebagai arsitektur yang saling bersaing justru menyembunyikan keputusan desain yang penting.
Saya membedakannya melalui tiga pertanyaan: bagaimana agen menentukan langkah berikutnya, bagaimana permintaan tool direpresentasikan, dan bagaimana aplikasi terhubung ke tool. ReAct, tool calling terstruktur, dan Model Context Protocol (MCP) menjawab pertanyaan ini pada tingkat yang berbeda. Tulisan ini mengembangkan pembedaan tersebut, memeriksanya melalui literatur, lalu menerapkannya pada contoh tiket dan rapat. Seluruh data project, jejak eksekusi, dan kode di bawah bersifat ilustratif; semuanya bukan hasil sistem yang sudah diterapkan atau benchmark baru.
Tiga pertanyaan di balik satu perbandingan
Pertama, perhatikan alur kontrol. Apakah kode aplikasi menetapkan urutan operasi, atau model boleh merevisinya setelah melihat bukti? Kedua, perhatikan representasi tindakan. Apakah aplikasi mengekstrak perintah dari teks yang dihasilkan, atau menerima objek pemanggilan tool yang terstruktur? Ketiga, perhatikan koneksinya. Apakah aplikasi memanggil fungsi lokal, adapter layanan khusus, atau server MCP?
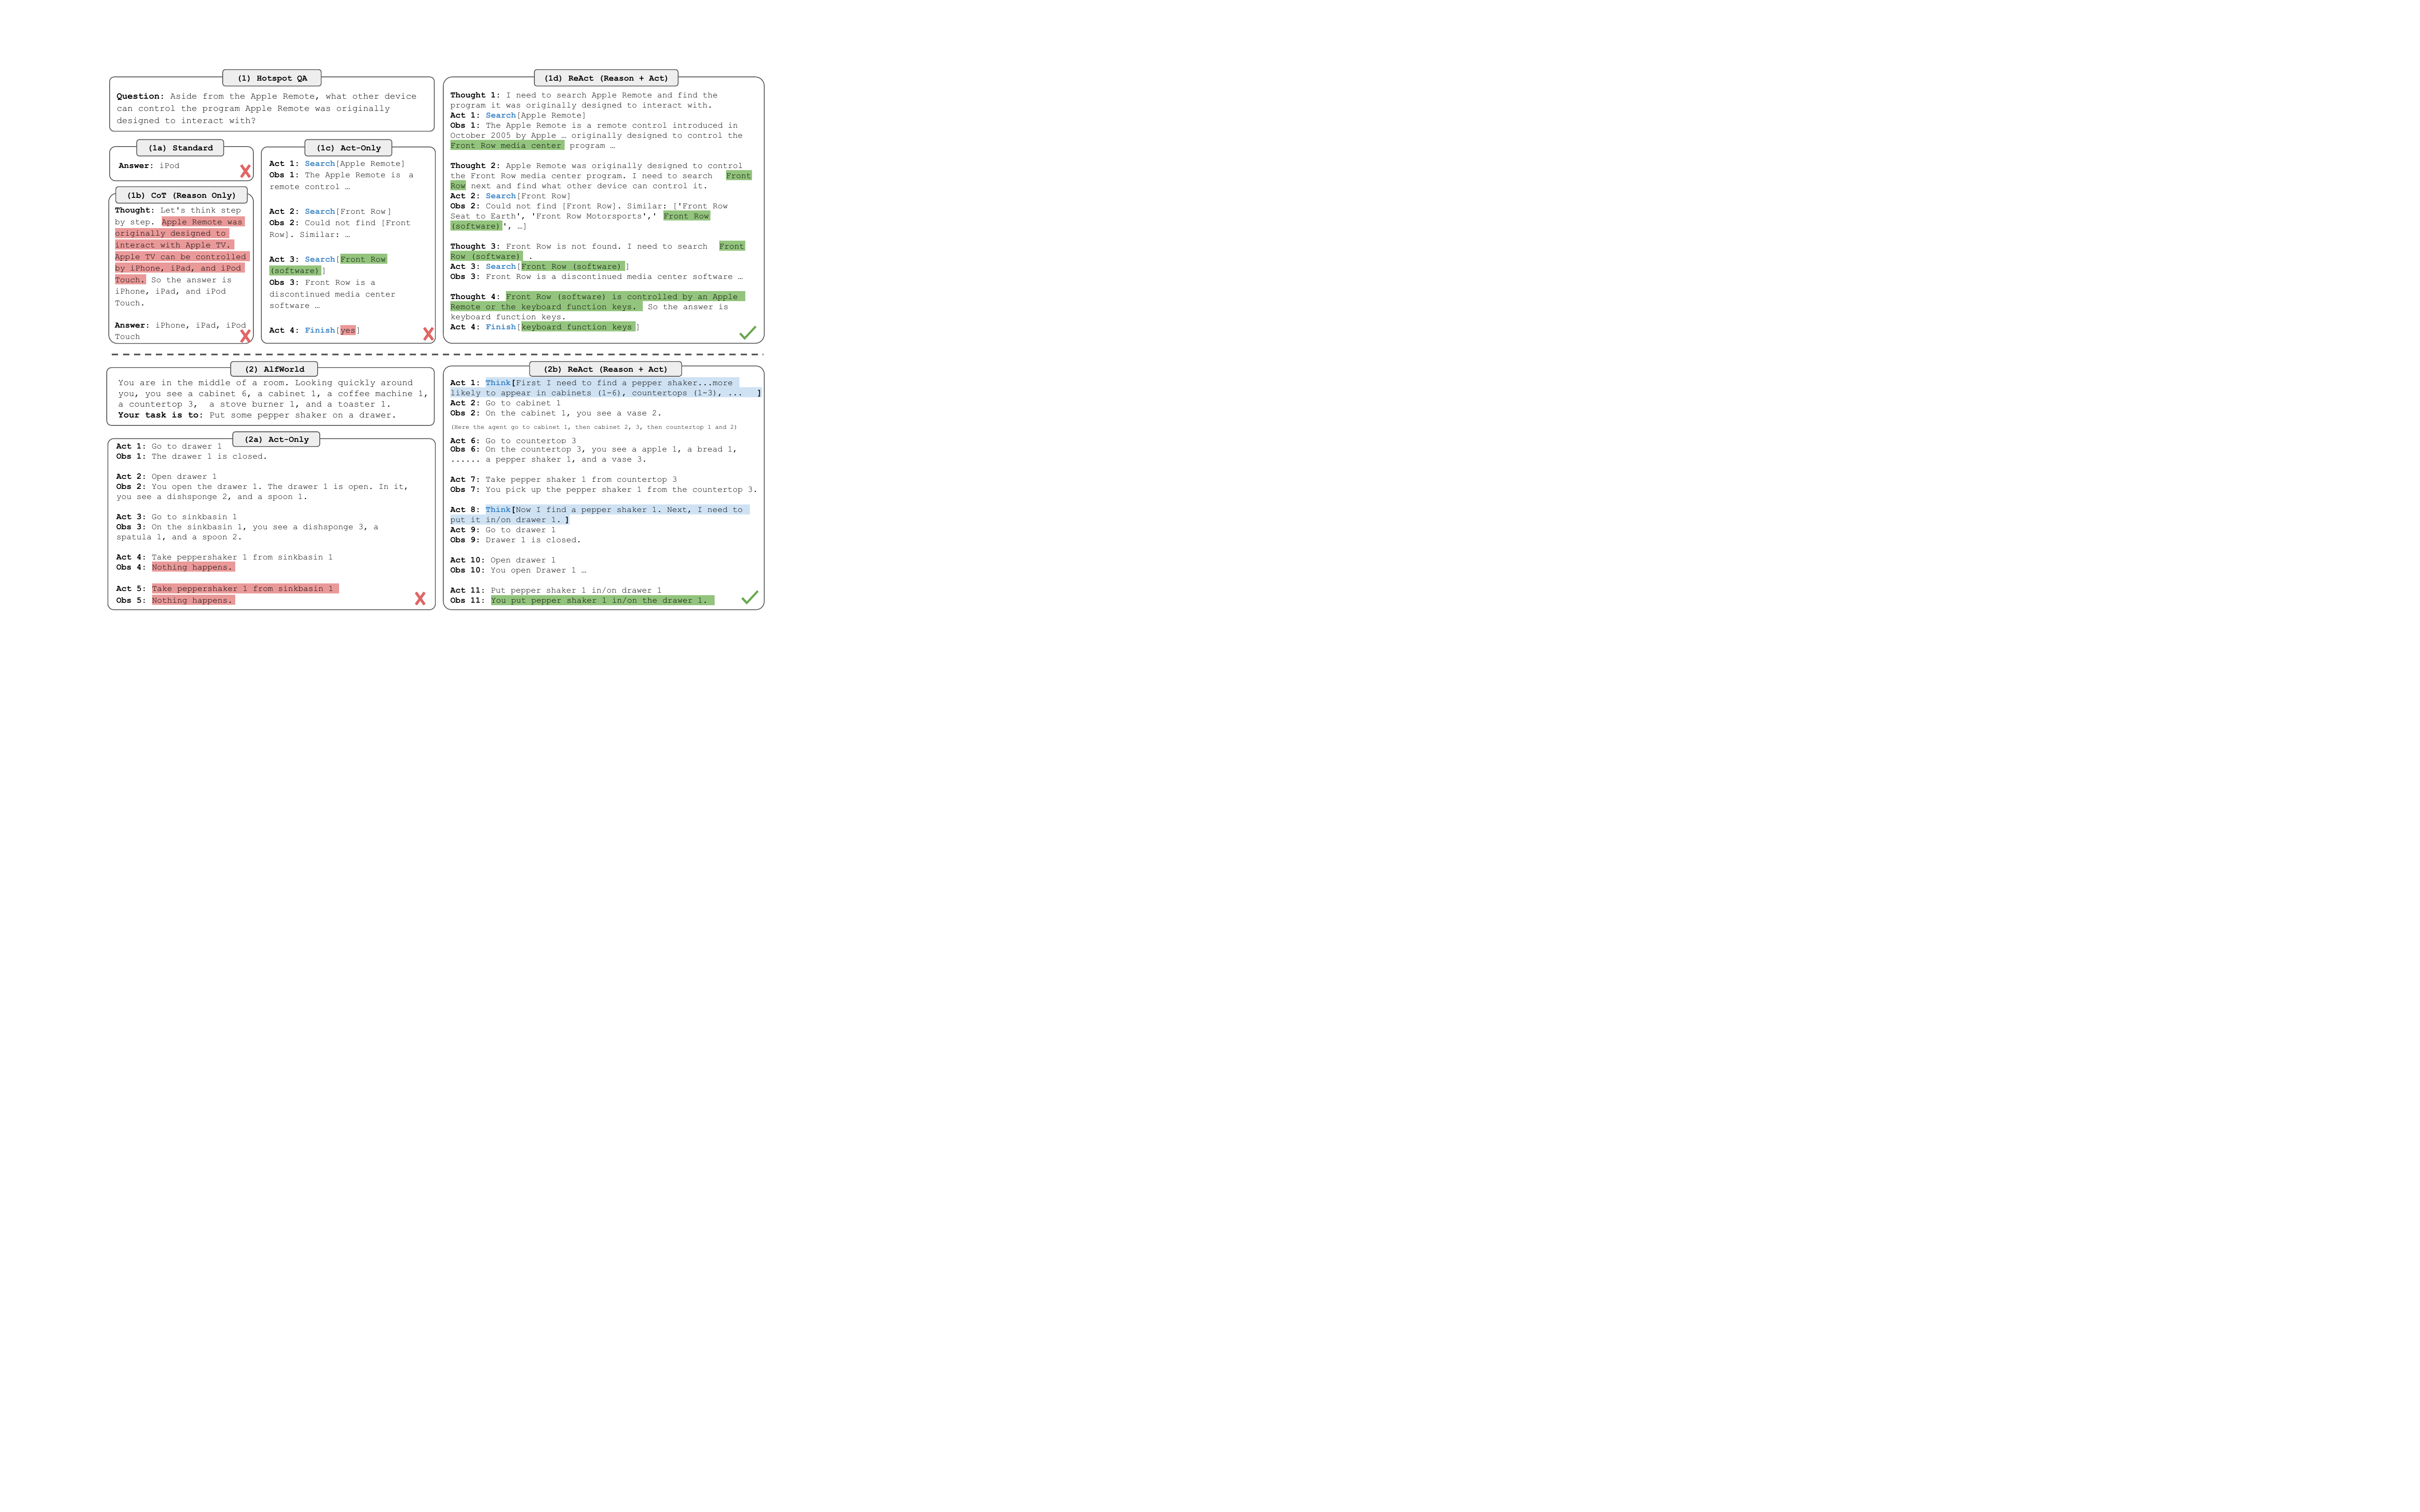
Gambar 1. ReAct menyelingi pemikiran yang dihasilkan model dengan tindakan dan pengamatan lingkungan, berbeda dari prompting yang hanya bernalar atau hanya bertindak. Gambar: Yao dkk. (2023), ReAct, CC BY 4.0.
Pemisahan ini mengubah cara saya meninjau usulan agen. “Kami memakai function calling” belum menjelaskan kapan agen berhenti. “Kami memakai ReAct” belum menjelaskan validasi argumen. “Kami memakai MCP” belum menjelaskan pemilihan tindakan berikutnya. Desain lengkap memerlukan jawaban pada setiap tingkat, meskipun sebagian besar infrastruktur disediakan framework.
Kontribusi ReAct
Yao dkk. memperkenalkan ReAct sebagai penyelingan penalaran verbal dengan tindakan dan pengamatan. Penalaran dapat mengarahkan atau merevisi rencana tindakan; tindakan membawa informasi eksternal kembali ke konteks. Paper tersebut mempelajari HotpotQA, FEVER, ALFWorld, dan WebShop.1
Untuk contoh kita, sketsa penjelasannya seperti berikut:
Task: Explain the current blockers for Project X.
Decision: Retrieve blocked tickets before looking for explanations.
Action: search_tickets(project_id="PX", status="blocked")
Observation: PX-17 and PX-24 are blocked.
Decision: Search meeting notes using these exact identifiers.
Action: search_meetings(ticket_ids=["PX-17", "PX-24"])
Observation: PX-17 has a recent discussion; PX-24 has none.
Next step: Check the PX-17 discussion and report the PX-24 gap.
Baris “Decision” merupakan penjelasan yang ditulis untuk pembaca, bukan klaim untuk menyingkap penalaran privat model. Perhatikan ketergantungannya: pencarian rapat memakai ID yang ditemukan melalui pencarian tiket. Jika tool pertama justru mengembalikan nama project yang ambigu, langkah lanjutan yang tepat akan berubah.
Dalam perbandingan prompting PaLM-540B di paper tersebut, ReAct meningkatkan hasil baseline yang hanya bertindak pada kedua tugas pengetahuan, tetapi tertinggal dari chain-of-thought di HotpotQA. Penulis juga melaporkan kegagalan berupa tindakan berulang.1 Temuan ini berguna untuk mempelajari umpan balik dan penalaran secara bersamaan, dengan hasil yang bergantung pada tugas. Namun, ini bukan perbandingan terkontrol terhadap antarmuka tool calling native saat ini.
Apa yang berubah dengan tool calling terstruktur
Antarmuka terstruktur menyediakan field bernama untuk operasi yang diminta beserta argumennya. Untuk tool sisi klien, aplikasi mengeksekusi permintaan lalu mengirimkan hasilnya kembali ke model. Perjalanan bolak-balik ini tetap ada meskipun SDK menanganinya secara otomatis. Beberapa penyedia menawarkan kepatuhan skema yang ketat, yang lebih kuat daripada sekadar meminta JSON.2
Berikut skema input search_tickets yang sengaja dibuat kecil dan tidak terikat penyedia tertentu:
{
  "type": "object",
  "properties": {
    "project_id": { "type": "string" },
    "status": { "enum": ["open", "blocked", "closed"] }
  },
  "required": ["project_id", "status"],
  "additionalProperties": false
}
Berikut contoh pertukaran datanya. Nama field menggambarkan contoh kita, bukan format komunikasi vendor tertentu:
{
  "call_id": "c1",
  "name": "search_tickets",
  "arguments": { "project_id": "PX", "status": "blocked" }
}
{
  "call_id": "c1",
  "result": {
    "tickets": [{ "id": "PX-17" }, { "id": "PX-24" }],
    "next_cursor": null
  }
}
Manfaat praktisnya adalah batas yang lebih jelas antara permintaan yang dihasilkan model dan operasi yang dapat dieksekusi. Parser dapat mengenali nama tool tanpa menebak apakah sebuah kalimat merupakan komentar atau perintah. Aplikasi dapat menolak status yang tidak didukung sebelum mengakses database.
Namun, "project_id": "WRONG-PROJECT" tetap memenuhi skema ini. Begitu pula permintaan tiket yang sudah ditutup ketika pengguna menanyakan hambatan. Permintaan dengan format benar hanyalah salah satu syarat tindakan yang benar. Contoh ini memerlukan pemeriksaan terpisah untuk identitas project, hak akses, dan apakah materi yang ditemukan menjawab pertanyaan.
Toolformer memberikan pembedaan lain yang berguna. Schick dkk. melatih model untuk menyisipkan pemanggilan API yang bermanfaat ke dalam teks melalui penyaringan self-supervised, bermula dari beberapa demonstrasi per tool. Tool-nya mencakup kalkulasi, pencarian, penerjemahan, dan kalender.3 Mempelajari kapan dan bagaimana memakai tool adalah persoalan pelatihan model; merepresentasikan permintaan sebagai field terstruktur adalah persoalan antarmuka. Masing-masing belum menentukan seluruh alur aplikasi.
Membandingkan pilihan desain yang sebenarnya
Berikut perbandingan desain, bukan papan peringkat performa. Tabel ini memisahkan pilihan yang sering digabungkan dalam istilah “agen”.
| Pilihan | Yang dikendalikan | Yang masih perlu diselesaikan |
|---|---|---|
| Tindakan berbasis teks atau pemanggilan terstruktur | Cara aplikasi membaca permintaan | Apakah tindakan yang diminta tepat |
| Workflow tetap atau loop adaptif | Siapa yang memilih operasi berikutnya | Kualitas bukti dan kondisi berhenti |
| Tool berurutan atau bersamaan | Kapan pekerjaan independen dijalankan | Ketergantungan dan operasi yang bertentangan |
| Adapter langsung atau MCP | Cara tool ditemukan dan dipanggil | Makna tool dan kebijakan aplikasi |
Untuk pertanyaan “Tampilkan status PX-17”, saya akan memulai dari pencarian tetap dan jawaban singkat. Untuk “Jelaskan mengapa tiket-tiket ini masih terhambat”, saya akan mengizinkan retrieval lanjutan karena sumber yang diperlukan mungkin baru ditemukan sepanjang proses. Ini usulan desain untuk contoh kita, bukan bukti bahwa otonomi lebih besar selalu menghasilkan jawaban lebih baik.
Artikel engineering Anthropic juga membedakan workflow yang telah ditentukan dari sistem yang membiarkan model mengarahkan penggunaan tool-nya sendiri, serta menyarankan agar kompleksitas dibenarkan oleh kebutuhan tugas.4 Kesimpulan saya: evaluasi tingkat kendali model paling kecil yang sudah memadai. Antarmuka terstruktur bisa digunakan pada keduanya.
Latensi mengikuti ketergantungan
Mengubah perintah teks menjadi JSON tidak membuat ID tiket yang belum diketahui tersedia lebih awal. Dalam contoh kita, retrieval rapat tetap harus menunggu penemuan tiket. Setelah PX-17 dan PX-24 diketahui, riwayat keduanya dapat diambil secara bersamaan jika tool dan aplikasi mendukung pola tersebut.
Untuk graph sederhana ini, model latensi ilustratifnya adalah:
Di sini, adalah total waktu dalam giliran model; suku lainnya menggambarkan pekerjaan aplikasi. Ini sketsa penjadwalan, bukan latensi terukur. Asumsinya retrieval riwayat berjalan bersamaan, tanpa retry, dan tahap-tahap tersebut tidak tumpang tindih dengan inferensi model. Retrieval berurutan mengganti nilai maksimum dengan penjumlahan. Mengubah format pemanggilan saja tidak membenarkan perubahan pada kedua rumus tersebut.
Agen gabungan, langkah demi langkah
Mari buat contohnya lebih konkret. Anggap pengguna sudah memilih project dengan ID PX. Tool tiket melaporkan PX-17 dan PX-24 masih terhambat saat data diambil. PX-17 terhubung ke rapat yang membahas peninjauan akses yang belum selesai. PX-24 tidak memiliki catatan rapat yang cocok dalam koleksi yang dicari.
Jawaban pertama tidak boleh menggeneralisasi penjelasan PX-17 ke kedua tiket. Pencarian yang tidak berhasil juga tidak membuktikan PX-24 tidak pernah dibahas. Jawaban yang berguna memisahkan status terkini, bukti yang ditemukan, dan kesenjangan yang tersisa.
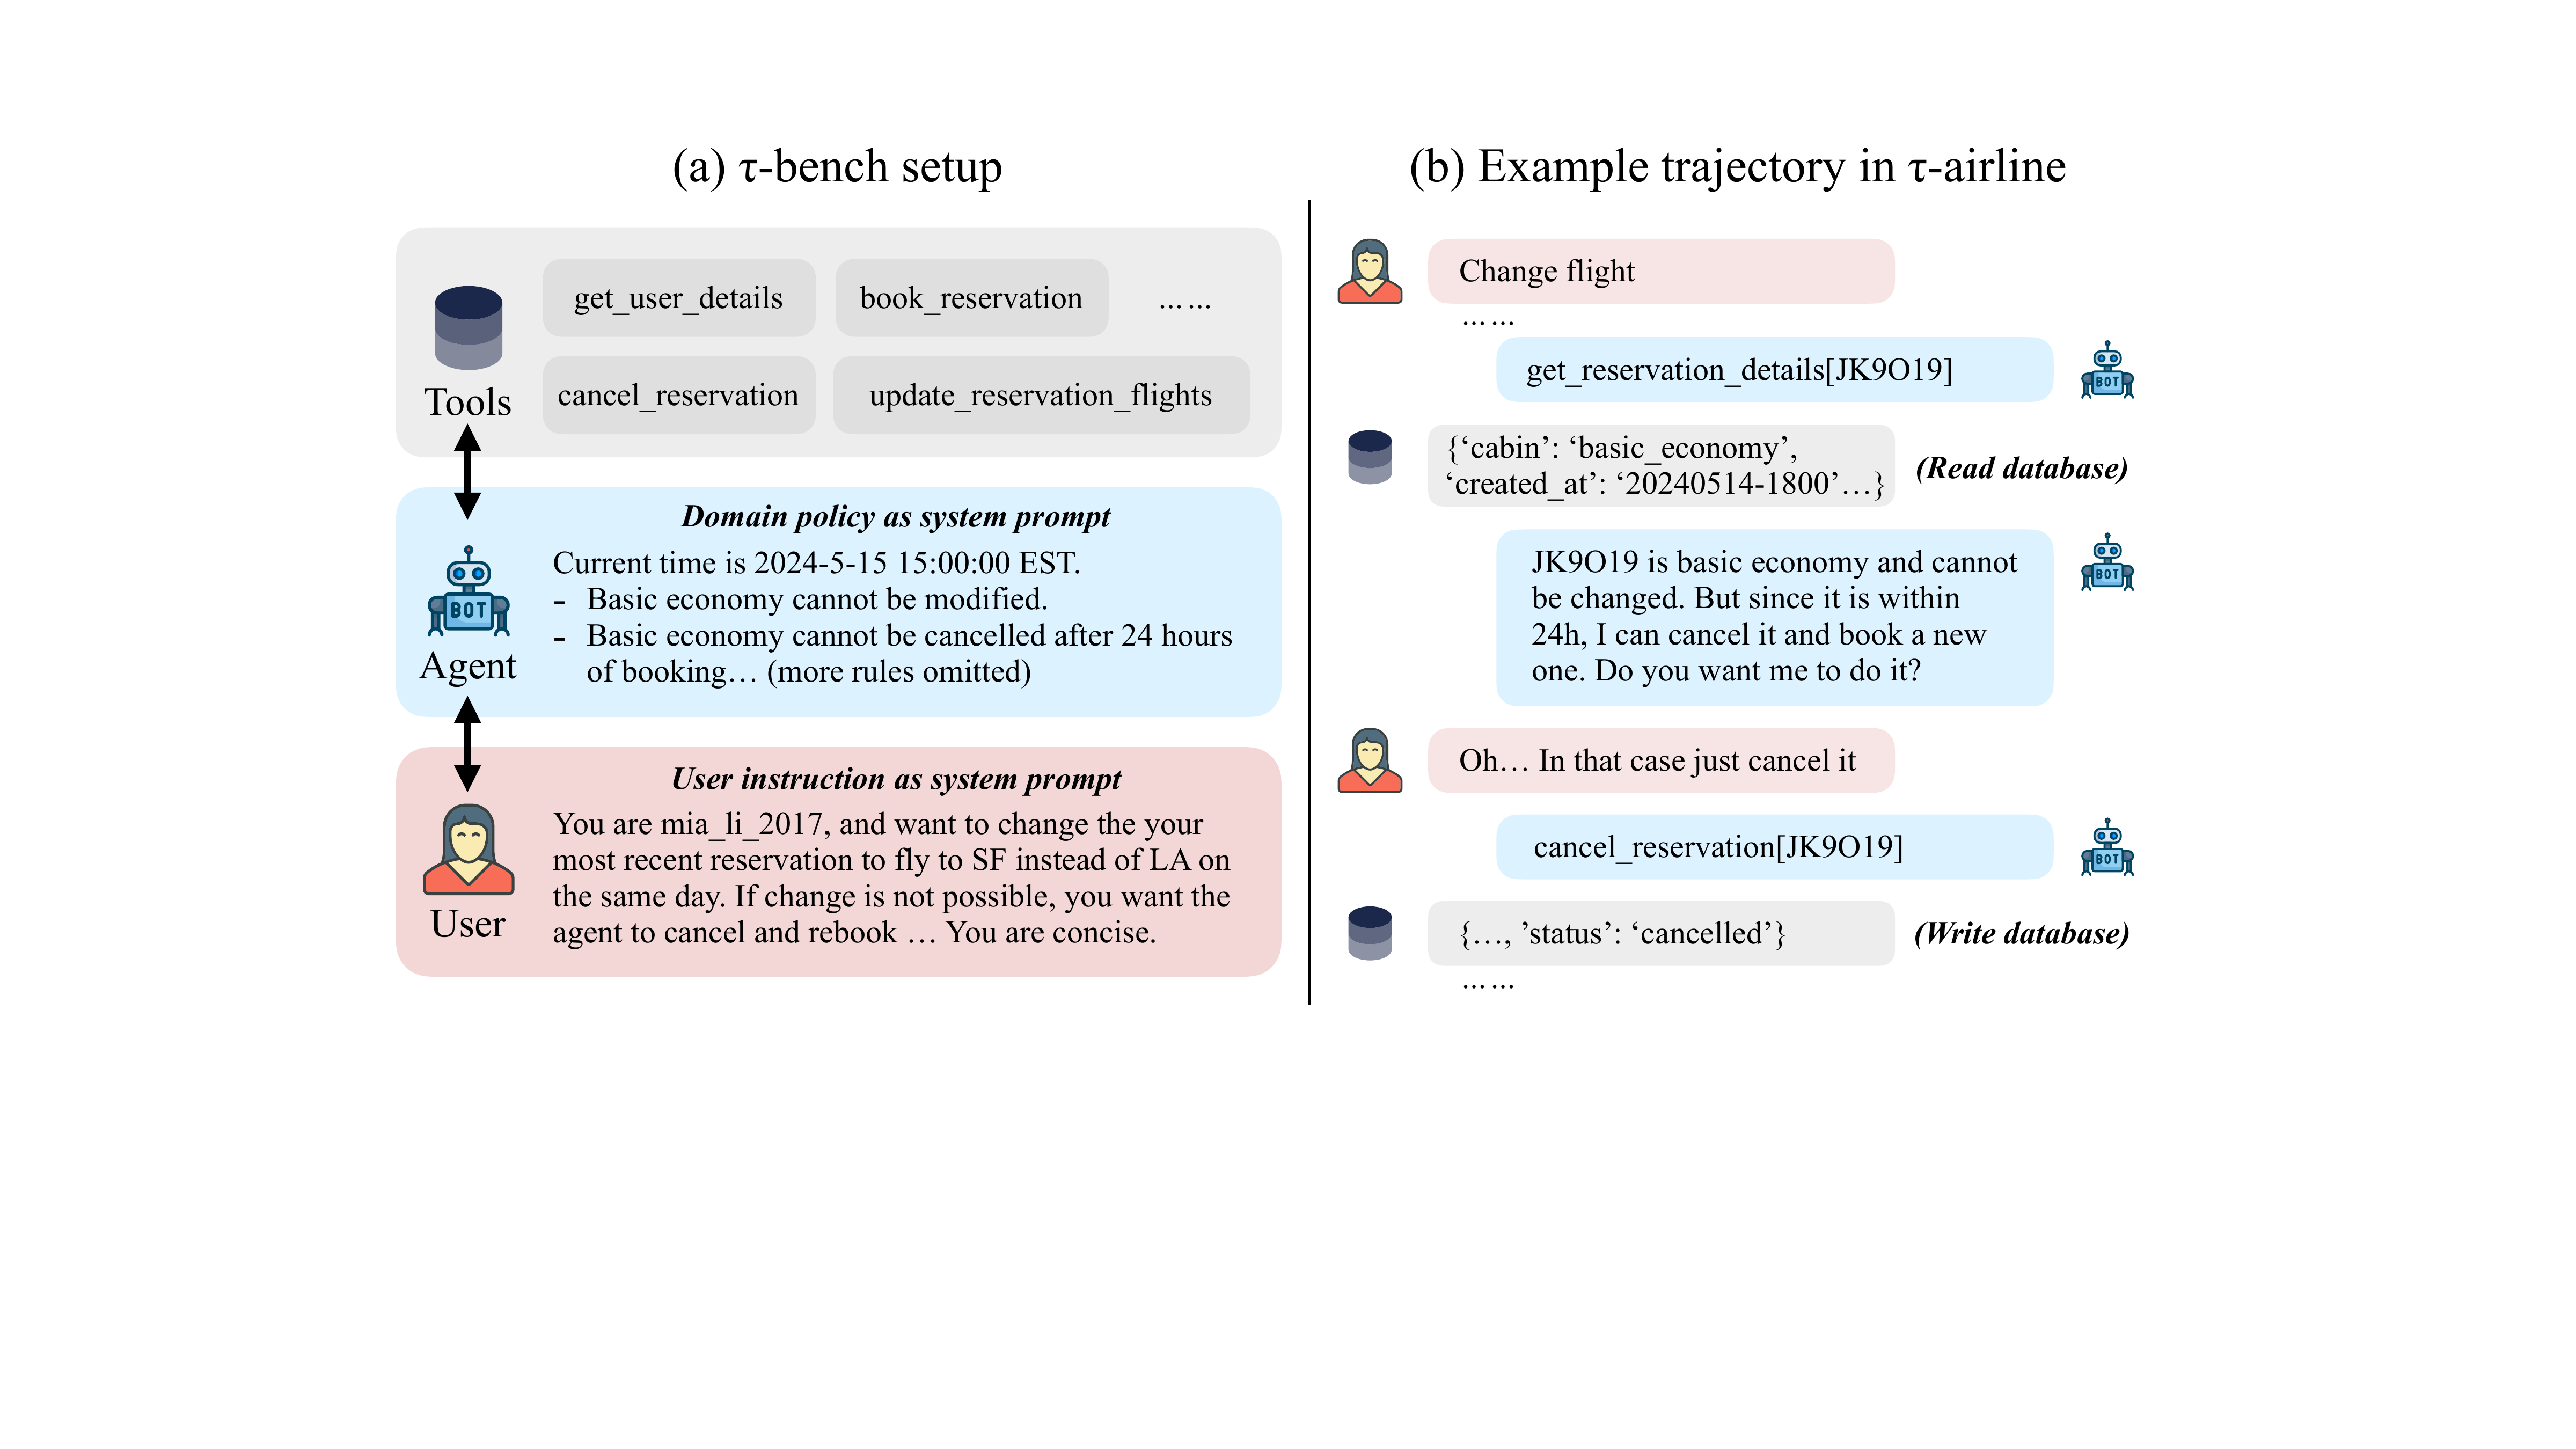
Gambar 2. Agen tool yang realistis berada di antara pengguna, dokumen kebijakan, dan API database. Gambar juga menunjukkan rangkaian tindakan maskapai yang dibatasi kebijakan. Gambar: Yao dkk. (2024), τ-bench, CC BY 4.0.
Pertahankan batas bukti
Untuk PX-17, saya akan menyimpan ID tiket, status yang diamati, waktu pengambilan, ID rapat, dan potongan relevan secara bersamaan. Jika rapat lebih lama daripada pembaruan tiket berikutnya, jawaban harus memperlihatkan urutan waktu tersebut. Pernyataan lama “peninjauan akses masih tertunda” adalah bukti hambatan terdahulu, bukan bukti otomatis mengenai penyebab saat ini.
Untuk PX-24, saya akan menulis “Tidak ditemukan penjelasan dalam catatan rapat yang dicari”, lalu menyebutkan cakupan pencariannya. Kalimat tersebut tetap membuka kemungkinan adanya rapat yang belum diindeks, ID yang hilang, atau diskusi di luar rentang tanggal. Pengguna juga mendapatkan informasi konkret untuk dikoreksi.
Di sinilah desain output tool berpengaruh. Panduan Anthropic menyarankan respons relevan dan ringkas, paginasi atau pemotongan hasil besar, serta error yang memberi langkah tindak lanjut.5 Untuk tool kita, berarti mengembalikan cukup informasi asal-usul agar jawaban dapat diperiksa, disertai cursor atau indikator cakupan. Memasukkan setiap field tiket ke konteks justru menyulitkan pencarian beberapa field yang menentukan kesimpulan.
Buat loop tetap eksplisit
Pseudocode berikut menggambarkan controller hanya-baca. model_turn menormalkan respons khusus penyedia sambil mempertahankan state percakapan yang dibutuhkan. observe mencatat hasil sesuai ID pemanggilannya. Skema tool, timeout, dan daftar tool yang diizinkan merupakan tanggung jawab aplikasi.
history = start_conversation(question)
attempts = Counter()

for turn in range(8):
    reply = model_turn(history, tools=READ_ONLY_TOOLS)
    history.append(reply)

    if not reply.calls:
        return answer_with_evidence_or_gaps(reply, history)

    for call in reply.calls:
        if call.name not in READ_ONLY_TOOLS:
            observe(history, call.id, error="Unknown tool")
            continue
        if not valid_arguments(call):
            observe(history, call.id, error="Invalid arguments")
            continue

        key = (call.name, canonical_json(call.arguments))
        if attempts[key] >= 2:
            observe(history, call.id, error="Repeat limit reached")
            continue

        attempts[key] += 1
        try:
            result = execute_with_timeout(call, seconds=10)
        except ToolTimeout:
            result = {"error": "Timed out", "retryable": True}
        except ToolError as exc:
            result = safe_error_result(exc)
        observe(history, call.id, result=result)

return partial_answer_with_gaps(history, reason="Step limit")
Batas delapan giliran, dua percobaan untuk permintaan identik, dan timeout sepuluh detik hanyalah nilai awal ilustratif, bukan nilai optimal hasil penelitian. Sketsa ini menjalankan pemanggilan secara berurutan agar jelas. Controller sungguhan juga memerlukan tenggat total dan anggaran pemanggilan; beberapa pemanggilan per giliran membuat batas giliran saja tidak membatasi seluruh pekerjaan.
Aturan pengulangan sengaja konservatif untuk retrieval hanya-baca. Aturan ini mengizinkan satu retry, tetapi juga dapat menghalangi penyegaran data yang bermanfaat. Jika data berubah selama tugas, desain produksi harus membedakan retry dari pengamatan baru yang disengaja. Operasi tulis memerlukan desain otorisasi dan pencegahan eksekusi ganda tersendiri; controller ini tidak mencakupnya.
Apa yang dapat disimpulkan dari bukti penelitian
Penelitian-penelitian ini membahas bagian sistem yang berbeda. Hasilnya lebih berguna jika kita membedakan perbandingan konfigurasi agen lengkap dari eksperimen yang hanya mengisolasi format tindakan.
| Sumber dan pertanyaan | Temuan yang dilaporkan | Batas kesimpulan |
|---|---|---|
| ReAct: apakah penalaran membantu tindakan? | Exact match HotpotQA: ReAct 27,4%, Act 25,7%, CoT 29,4% dengan PaLM-540B | Perbandingan prompting historis, bukan ablasi antarmuka tool native |
| Toolformer: bisakah penggunaan tool dipelajari? | Augmentasi API self-supervised meningkatkan beberapa tugas lanjutan | Tidak membuktikan penyelesaian workflow sembarang secara andal |
| τ-bench: bisakah agen menyelesaikan tugas secara konsisten? | Function calling GPT-4o: 61,2% retail, 35,2% maskapai; rata-rata domain 48,2% | Model historis dan domain simulasi; kedua domain diberi bobot sama |
| Turpin dkk.: apakah penjelasan setia pada proses sebenarnya? | Bias input dapat memengaruhi jawaban tanpa disebutkan dalam penjelasan | Mengkaji kesetiaan CoT, bukan performa agen tiket ini |
Temuan terpilih dari penelitian asli.1367 Angka pada baris ReAct mengambil sebagian entri Tabel 1; angka tersebut bukan peringkat sistem saat ini.
τ-bench mengevaluasi percakapan dengan pengguna simulasi, kebijakan, dan API melalui pemeriksaan state database akhir. Perbandingan retail-nya juga menemukan function calling native lebih unggul daripada ReAct berformat teks untuk model yang diuji, sedangkan ReAct mengungguli prompting teks yang hanya bertindak.6 Temuan ini relevan untuk memilih antarmuka, meskipun konfigurasinya berbeda dalam prompting dan penggunaan kemampuan native; hasilnya tidak menunjukkan bahwa penalaran berbasis umpan balik bertentangan dengan pemanggilan terstruktur.
Paper tersebut mengukur konsistensi dengan : keberhasilan pada seluruh percobaan, bukan setidaknya satu percobaan berhasil.6 Pembedaan ini penting ketika pengguna mengharapkan permintaan valid yang sama dapat dijalankan berulang kali.
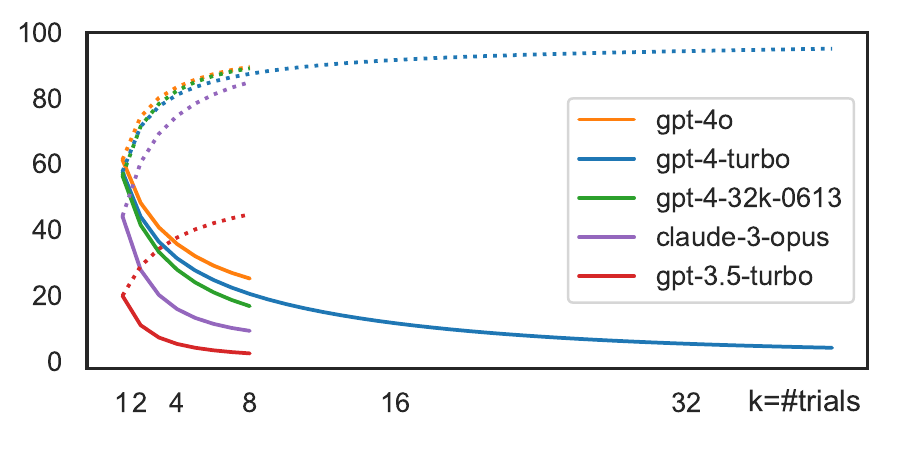
Gambar 3. Rata-rata keberhasilan dapat menyembunyikan perilaku tidak stabil: menurun ketika setiap dari percobaan harus berhasil. Gambar: Yao dkk. (2024), τ-bench, CC BY 4.0.
Menurut saya, evaluasi agen harus membedakan tiga hasil: pemanggilan diterima, informasi yang diminta ditemukan, dan tugas pengguna selesai dengan benar. Dashboard yang hanya melaporkan hasil pertama dapat terlihat sehat, padahal pengguna mendapat penjelasan yang salah.
Jejak yang mudah dibaca bukanlah bukti
Turpin dkk. menunjukkan bahwa penjelasan chain-of-thought dapat merasionalisasi prediksi yang dipengaruhi bias input tanpa menyebutkan pengaruhnya.7 Ini tidak membuktikan setiap penjelasan tidak setia pada prosesnya. Namun, temuan tersebut melemahkan asumsi bahwa penjelasan yang meyakinkan sudah cukup sebagai audit.
Untuk contoh kita, saya akan memeriksa permintaan sebenarnya, potongan teks yang diambil, tanggalnya, dan klaim yang dihasilkan. Kalimat “Saya sudah memeriksa rapat terbaru” harus bisa diuji melalui log. Jika tidak ada rapat yang diambil, komentar yang fasih tidak boleh menyelamatkan jawaban. Sebaliknya, tidak adanya jejak penalaran yang terlihat tidak menghalangi audit ketika tindakan dan catatan pendukung tersedia.
Uji kasus kegagalan secara sengaja
Saya akan membuat kumpulan fixture kecil khusus aplikasi ini sebelum membandingkan strategi prompting. Isinya mencakup dua project bernama mirip, tiket dengan penjelasan rapat kedaluwarsa, hasil berhalaman, error tool sementara, dan hambatan tanpa rapat pendukung. Setiap kasus menguji alasan berbeda mengapa rangkaian tindakan yang tampak masuk akal dapat gagal.
Evaluator harus memeriksa apakah setiap tiket yang dilaporkan termasuk project terpilih, apakah statusnya sesuai fixture, dan apakah setiap penjelasan mengutip potongan yang benar-benar diambil. Evaluator harus menerima pernyataan kesenjangan bukti ketika koleksi tidak memiliki bukti. Ia harus menolak penjelasan percaya diri yang dipinjam dari tiket lain, meskipun seluruh pemanggilan valid.
Pada fixture yang sama, catat penyelesaian tugas, klaim tanpa dukungan, error tool, pemanggilan berulang, waktu, dan penggunaan token. Bandingkan workflow tetap dengan loop adaptif sambil mempertahankan model dan akses tool yang sama. Ulangi percobaannya. Ini eksperimen yang diusulkan, bukan hasil tulisan ini. Hasilnya akan menunjukkan apakah keputusan tambahan cukup meningkatkan aplikasi untuk membenarkan biayanya.
Posisi MCP
MCP menyediakan protokol bersama untuk mengekspos tool: klien dapat menemukan definisi melalui tools/list dan memanggilnya melalui tools/call. Definisi mencakup skema input; hasil dapat berupa konten terstruktur atau tidak terstruktur. Spesifikasi juga membahas error dan mengingatkan agar anotasi tool dari server tidak tepercaya tidak langsung dipercaya.8
Dalam contoh kita, layanan rapat dapat menyediakan kemampuan retrieval yang sama bagi beberapa aplikasi agen yang kompatibel. Aplikasi memetakan definisi tool ke antarmuka yang dilihat model dan meneruskan permintaannya kembali ke server. Pemetaan ini tetap pekerjaan aplikasi; model tidak otomatis menjadi klien MCP hanya karena menghasilkan objek JSON.
Dampak arsitektur yang berguna adalah batas koneksi yang bisa dipakai ulang. Ini tidak berarti dua server rapat menghasilkan bukti setara. Satu mungkin mengindeks transkrip, sedangkan yang lain hanya ringkasan; pencarian yang tampak identik bisa memiliki cakupan berbeda. Saya akan mendokumentasikan perbedaan ini dalam deskripsi tool dan mempertahankannya dalam informasi asal-usul jawaban.
Saya juga akan memperlakukan teks rapat yang diambil sebagai bukti untuk ditafsirkan, bukan kewenangan untuk mengubah tugas atau memberikan kemampuan baru. Catatan berisi “abaikan status tiket” tetaplah catatan. Dalam contoh ini, daftar tool hanya-baca mencegah potongan teks membuka jalur sah untuk mengubah tiket. Namun, batas tersebut saja tidak mencegah teks menyesatkan memengaruhi jawaban.
Hal yang perlu diingat
- Pisahkan loop, format tindakan, dan koneksi tool saat membandingkan desain agen.
- Gunakan pemanggilan terstruktur untuk memperjelas batas eksekusi, lalu validasi makna permintaan selain formatnya.
- Buktikan manfaat retrieval lanjutan lewat evaluasi tingkat tugas; jalankan bersamaan hanya pekerjaan yang ketergantungannya mengizinkan.
- Pertahankan identitas sumber, waktu, dan cakupan pencarian agar penjelasan dapat diperiksa dan kesenjangan bukti tetap terlihat.
- Ukur penyelesaian tugas dan keandalan percobaan berulang bersama validitas pemanggilan, latensi, dan biaya.
Untuk asisten tiket dan rapat, desain awal saya adalah loop terbatas dan hanya-baca, dengan pemanggilan tool terstruktur serta bukti yang bisa diperiksa. MCP menjadi pilihan koneksi ketika akses tool bersama bermanfaat. Keputusan selanjutnya datang dari evaluasi fixture: pertanyaan mana yang terbantu oleh retrieval adaptif, dan mana yang sudah dijawab dengan baik oleh urutan tetap?
Referensi
Ketiga gambar direproduksi dari paper berlisensi CC BY 4.0 dengan atribusi. Data Project X, jejak eksekusi, skema, controller, dan persamaan latensi tetap bersifat ilustratif, bukan hasil pengukuran.
Sitasi
Untuk merujuk tulisan ini:
Ma'ruf, Muhammad Rifqi. “ReAct vs Tool-Calling Agents.” rifqimaruf.dev (2026), direvisi 13 September 2026. https://rifqimaruf.dev/writing/react-vs-tool-calling-agents/
Footnotes
-
S. Yao dkk., “ReAct: Synergizing Reasoning and Acting in Language Models,” ICLR, 2023 (pracetak 2022). Paper. Lihat Bagian 2–4 dan Tabel 1. ↩ ↩2 ↩3
-
Anthropic, “Tool use with Claude,” dokumentasi pengembang. Dokumentasi. Diakses 13 September 2026; kemampuan API bergantung pada versi. ↩
-
T. Schick dkk., “Toolformer: Language Models Can Teach Themselves to Use Tools,” NeurIPS, 2023. Paper. ↩ ↩2
-
E. Schluntz dan B. Zhang, “Building effective agents,” Anthropic, 19 Desember 2024. Artikel engineering. Panduan praktisi, bukan benchmark terkontrol. ↩
-
K. Aizawa, “Writing effective tools for AI agents—using AI agents,” Anthropic, 11 September 2025. Artikel engineering. Lihat bagian evaluasi dan respons tool. ↩
-
S. Yao, N. Shinn, P. Razavi, dan K. Narasimhan, “τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains,” 2024. Paper. Tulisan ini mengacu pada penelitian asli 2024, bukan papan peringkat terkini. ↩ ↩2 ↩3
-
M. Turpin, J. Michael, E. Perez, dan S. R. Bowman, “Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting,” NeurIPS, 2023. Paper. ↩ ↩2
-
Model Context Protocol, “Tools,” revisi spesifikasi 2025-11-25. Spesifikasi. Diakses 13 September 2026. ↩