Analisis Sentimen Berbasis Aspek untuk Opini Publik Indonesia
- PyTorch
- Hugging Face
- LoRA
- NLP
- Gradio
Satu opini bisa mendukung sebagian kebijakan sekaligus mengkritik bagian lainnya. Kalau seluruh teks diberi satu label sentimen, perbedaan itu sulit terlihat. Prototipe ini mengeksplorasi analisis sentimen berbasis aspek (ABSA) pada opini Indonesia tentang bahan bakar minyak (BBM) dan pemilihan umum (Pemilu).
Proyek ini mengembangkan studi klasifikasi sentimen sebelumnya menjadi demo interaktif. Aku ingin pembaca bisa mencoba sebuah opini, melihat aspek yang mungkin dibahas, dan memahami bagaimana pilihan topik memengaruhi analisis.
Mengenal Prototipe ABSA
Memilih Topik dan Menulis Opini
Antarmuka dimulai dengan dua pilihan, Fuel (BBM) dan Elections, diikuti kolom teks opini. Topik menentukan lima aspek spesifik yang dipertimbangkan oleh demo.
Pada BBM, aspek tersebut meliputi harga, subsidi, ketersediaan, dampak ekonomi, dan tata kelola. Pada Pemilu, cakupannya meliputi jadwal, administrasi kepesertaan, integritas penyelenggara, kandidat dan partai, serta kampanye.
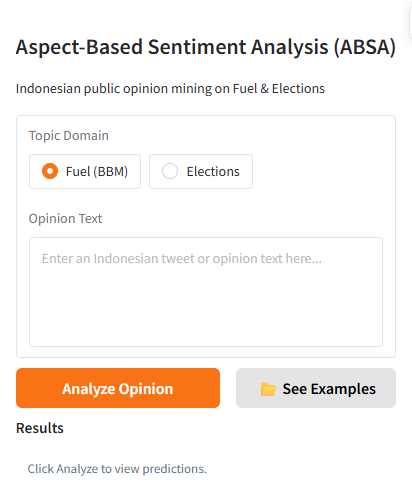
Satu area kerja untuk memilih topik, memasukkan opini berbahasa Indonesia, dan membaca hasilnya.
Membuka Drawer Contoh
Tombol See Examples membuka panel di samping input. Memilih contoh akan mengisi opini dan menyesuaikan topik secara otomatis. Pengguna bisa mencoba kedua domain tanpa mengetik ulang kalimat yang sama.
Contoh tersebut adalah kalimat demonstrasi yang disediakan aplikasi, bukan klaim bahwa semuanya merupakan kutipan terverifikasi dari akun nyata.
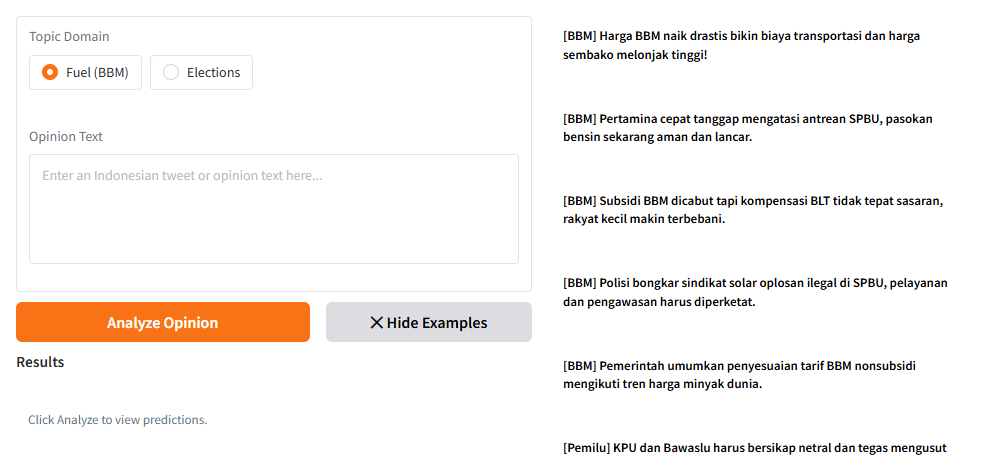
Contoh menjadi titik awal untuk mencoba interaksi aplikasi.
Membaca Hasil per Aspek
Tombol Analyze Opinion menghasilkan daftar aspek dan badge sentimen. Positive, Negative, dan Neutral memakai warna berbeda. Aspek yang diprediksi tidak disebutkan biasanya tidak ditampilkan. Ketika tidak ada hasil aspek, demo menampilkan General (Non-specific) — Neutral.
Contoh demo berikut menunjukkan bagaimana satu opini dapat menghasilkan beberapa label aspek.
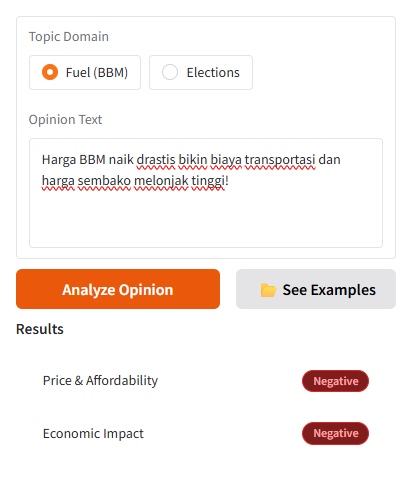
Pada contoh tentang kenaikan harga BBM, ongkos transportasi, dan sembako, demo menampilkan dua aspek dengan sentimen negatif.
Tugas klasifikasi pasangan dapat digambarkan sebagai berikut:
(teks, aspek) → sentimen

(teks, harga)        → Negatif
(teks, ketersediaan) → Positif
Ini menggambarkan tujuan analisis, bukan jaminan hasil untuk kalimat dengan sentimen campuran. Model tetap perlu menghubungkan sentimen dengan aspek yang tepat.
Di Balik Antarmuka
Aplikasi memakai Gradio, PyTorch, Transformers, dan PEFT. Sistem mencoba memuat adapter LoRA sesuai domain di atas indolem/indobertweet-base-uncased, kemudian melakukan tokenisasi pasangan teks–aspek dan memilih satu dari empat kelas.
Opini + topik
       ↓
Pasangan teks–aspek
       ↓
IndoBERTweet + adapter LoRA domain
       ↓
Pengolahan hasil
       ↓
Badge aspek dan sentimen
Model disimpan dalam cache setelah dimuat. Loader lokal memeriksa folder domain pada root aplikasi atau di dalam models/; berkas adapter harus ditempatkan sesuai lokasi tersebut. Keberadaan adapter di outputs/ saja belum membuat demo memuatnya.
Menyiapkan Data Aspek
CSV lokal hasil ekspansi memuat 1.200 teks sumber per domain. Setiap teks dipasangkan dengan enam kategori aspek, termasuk lainnya, sehingga menghasilkan 7.200 pasangan per domain. Demo saat ini memakai lima aspek bernama Inggris, sedangkan data latih memakai identifier aspek berbahasa Indonesia. Penyelarasan kedua representasi ini perlu diperiksa saat menyiapkan deployment.
Label awal dibuat melalui weak labeling berbantuan aturan, kemudian ditinjau dan diverifikasi oleh manusia.
| Domain | Teks sumber | Pasangan | Tidak disebutkan |
|---|---|---|---|
| BBM | 1.200 | 7.200 | 5.973 |
| Pemilu | 1.200 | 7.200 | 6.297 |
Runner ABSA membagi data berdasarkan tweet_id agar semua pasangan aspek dari satu teks berada pada partisi yang sama. Manifest persiapan BBM mencatat 4.320 pasangan latih, 1.440 validasi, dan 1.440 uji, dengan proporsi 60/20/20. Manifest ini dibuat pada mode prepare-only dan belum membuktikan training atau evaluasi telah selesai.
Full Fine-Tuning dan LoRA
Runner ABSA mendukung pelatihan seluruh parameter model maupun Low-Rank Adaptation (LoRA). Konfigurasi pada runner dan adapter tersimpan adalah:
| Pengaturan | Nilai |
|---|---|
| Model dasar | indolem/indobertweet-base-uncased |
| Rank LoRA | 8 |
| Alpha | 16 |
| Dropout | 0,1 |
| Target modul | query, value |
LoRA memungkinkan adaptasi domain dengan melatih matriks tambahan berukuran kecil, tanpa memperbarui seluruh bobot model dasar. Alasan memilih pendekatan ini berbeda dengan membuktikan peningkatan lewat eksperimen. Checkout yang diperiksa berisi adapter dan manifest persiapan, tetapi belum menyertakan laporan evaluasi ABSA yang mendukung perbandingan F1, memori GPU, atau waktu training. Karena itu, tulisan ini berfokus pada cara kerja prototipe, bukan hasil benchmark yang sudah tervalidasi.
Eksperimen sentimen tingkat teks dari studi awal juga merupakan tugas berbeda. Skor historisnya tidak dapat dipakai sebagai hasil ABSA atau bukti bahwa LoRA mencegah keruntuhan kelas.
Komentar
Bagikan pertanyaan atau masukan. Masuk dengan GitHub untuk berkomentar.